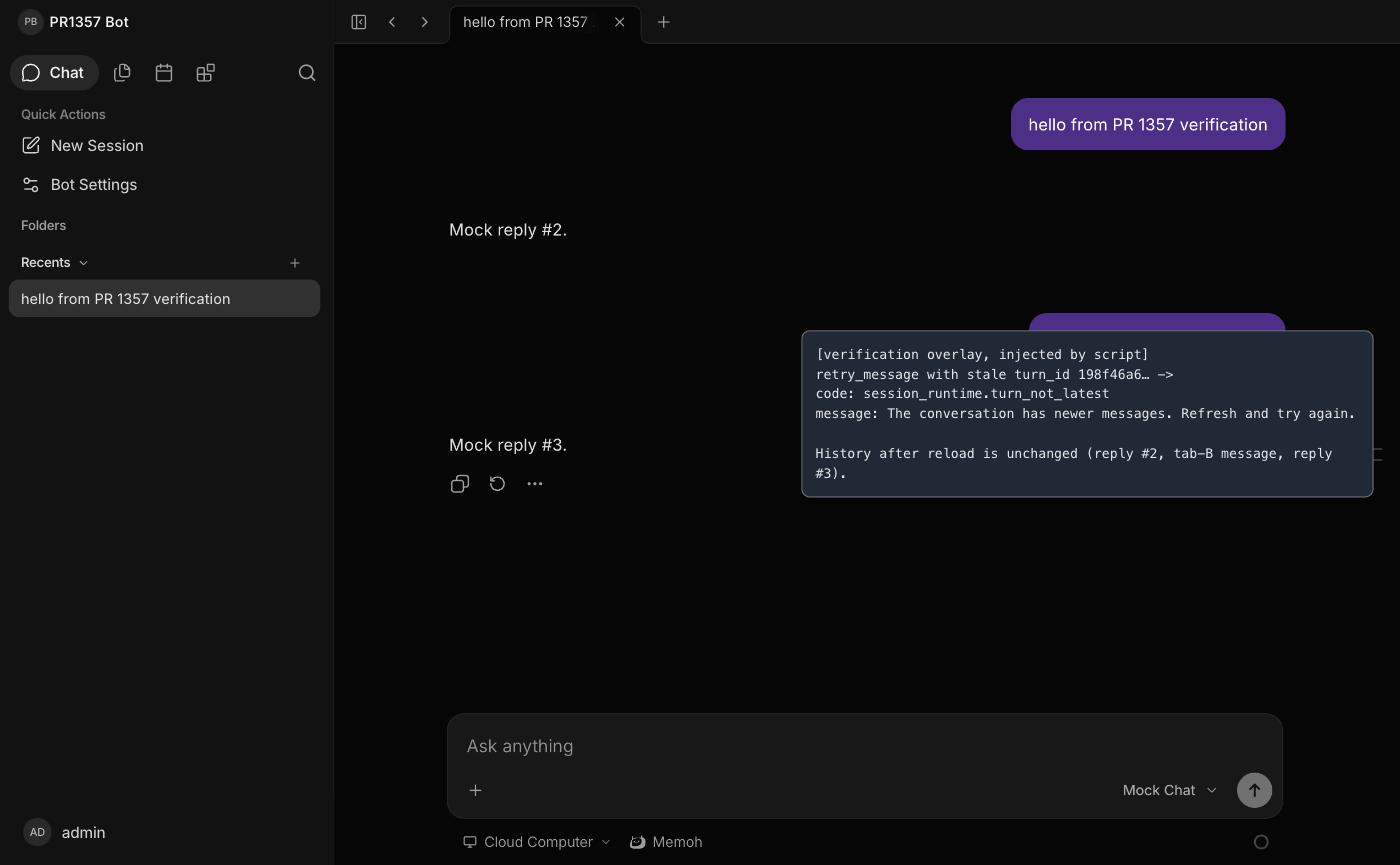
Memoh renvoie 409 quand un retry vise un ancien tour de conversation.
Le runtime sépare désormais les tours périmés des vraies incohérences d’historique, afin qu’un retry ou edit devenu obsolète ne soit plus traité comme une erreur serveur.
Memoh renvoie 409 quand un retry vise un ancien tour de conversation.
Le runtime sépare désormais les tours périmés des vraies incohérences d’historique, afin qu’un retry ou edit devenu obsolète ne soit plus traité comme une erreur serveur.

OpenAI fait du coût par tâche un argument central avec GPT-6 Sol et Luna : les deux modèles baissent d’au moins 50 % par rapport à leurs prédécesseurs, tandis que Sol vise le coding, la revue et le débogage répétés. Le routage entre modèles devient ainsi une décision économique du workflow, pas seulement un choix de benchmark.
Anthropic suit la même pression avec Opus 5.5 : le tarif de sortie tombe à 20 dollars par million de tokens, contre 25 dollars auparavant, tandis que l’éditeur revendique de meilleures performances et moins de tokens nécessaires par tâche. Pour les équipes, le coût utile dépend donc autant de l’efficacité d’exécution que du prix facial.
xAI maintient Grok 4.7 au prix de Grok 4.6, à partir de 2 dollars en entrée et 6 dollars en sortie, tout en ciblant les tâches longues de coding. Cette concurrence pousse les développeurs à mesurer coût par tâche réussie, contexte rejoué, cache et retries, puis à router chaque étape vers le modèle suffisant.
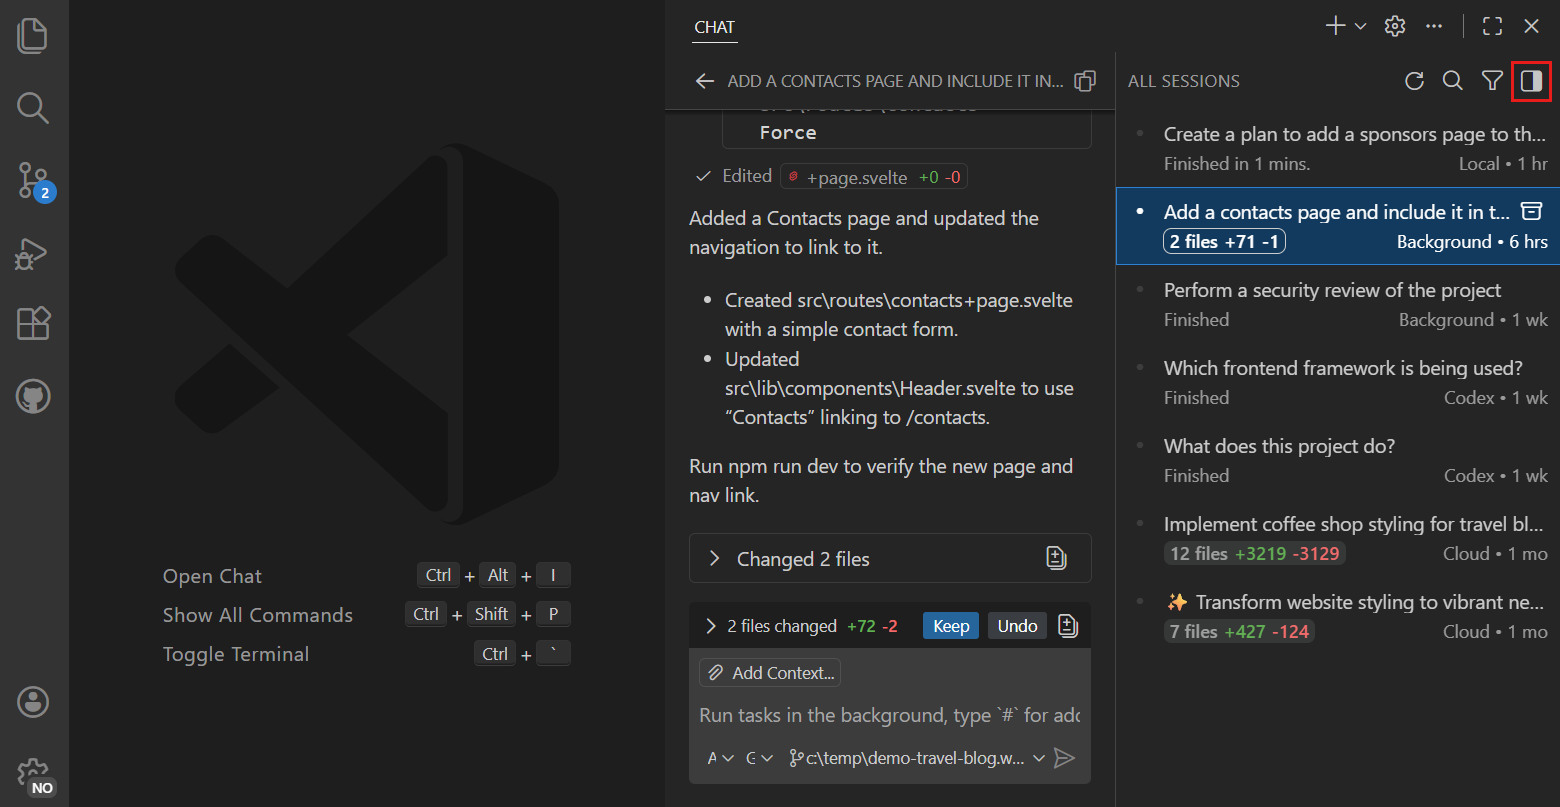
VS Code libère les identifiants de télémétrie Copilot à la fin de chaque tour.
Les sessions longues ne conservent plus les corrélations des tours terminés ; deux champs distinguent aussi les tours démarrés ou reçus par steering sans mêler leurs mesures.
OpenHands expose une visibilité unique pour les workspaces personnels.
L’API conserve le workspace personnel mais le marque invisible lorsqu’une équipe existe, afin qu’Agent Canvas et les autres clients cessent de reconstruire cette règle chacun de leur côté.
Lightdash réutilise une requête vérifiée sans relancer l’entrepôt de données.
Le premier pas de présentation reprend le résultat précédent après contrôle d’autorisation, SQL, paramètres et fraîcheur ; Jev borne aussi les nouvelles tentatives liées aux ressources.

Aikido répond au risque de fuite de code par le modèle lui-même : son modèle de cybersécurité Altar, dérivé de GLM-5.3, peut être déployé localement afin que les dépôts sensibles ne partent pas vers un fournisseur externe. Pour les équipes sécurité, le lieu d’inférence devient ainsi une propriété d’architecture, pas un simple choix de provider.
Benchling applique la même logique à l’exécution : le code scientifique généré par ses agents tourne dans un compte AWS séparé, sans accès Internet ni NAT, avec DNS en allowlist et identifiants temporaires par job. Les tests d’intégration simulent l’exfiltration et bloquent une release si le périmètre réseau se relâche, transformant l’isolation en propriété vérifiable.
L’incident ZCode montre l’autre côté du contrat : Caixin rapporte que l’outil a chiffré et envoyé des workspaces privés, avec historique Git, vers Alibaba Cloud sans consentement explicite, avant d’être open-sourcé. Pour les développeurs, indexation du dépôt, inférence, exécution de code et egress réseau doivent donc devenir quatre permissions séparées et auditées.
Qwen Code verrouille l’identité de son Managed Runtime avec un contrat unique.
Le contrat impose route exacte, authentification avant JSON, limites de 16 KiB et vérification du lease et du workspace, avec les mêmes fixtures côté TypeScript et Java.
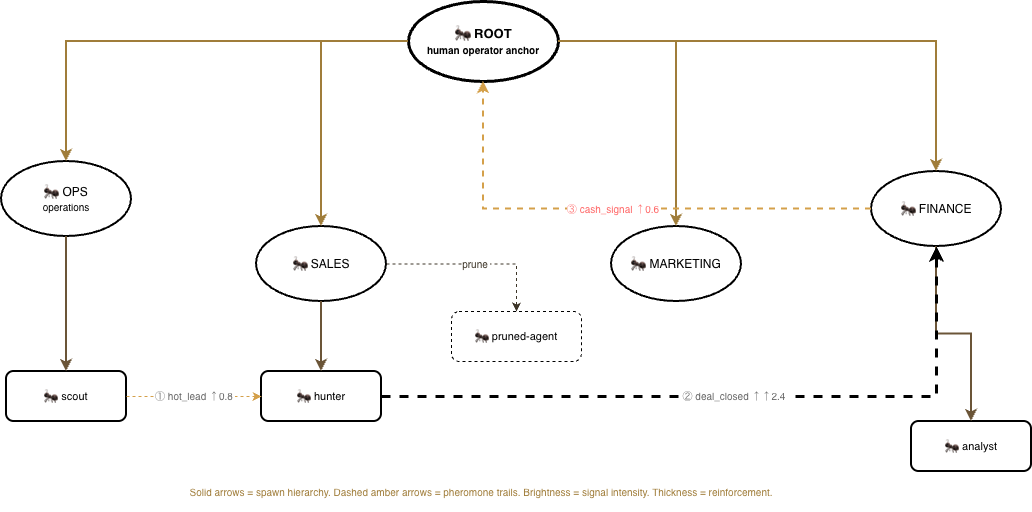
Ormica ajoute des runs auto-réparants avec circuit breaker et dead-letter.
Le runtime retente les tâches, isole un nœud qui échoue, peut rerouter vers la racine ou le recréer, puis parque les échecs persistants pour inspection.
V7 traite la mémoire comme une couche de données séparée du context window. Son Context Graph extrait entités, relations et preuves depuis des millions de fichiers, puis laisse les agents interroger cet historique via MCP. Pour les développeurs, conserver le passé ne suffit plus : il faut le structurer, le mettre à jour et relier chaque fait à sa source.
Le nouveau cycle de l’Agent Memory Leaderboard formalise ce besoin. Les systèmes sont évalués séparément sur mémoire textuelle, multimodale et coding agent, avec historique pertinent ou bruité, événements temporels et recherche cross-session. La mémoire devient ainsi un composant mesurable via une API Add/Search stable, plutôt qu’un effet opaque du prompt ou du modèle.
Cohesity ajoute la contrainte opérationnelle : une mémoire utile doit aussi pouvoir revenir à un état sain. Agent Resilience applique snapshots immuables et restauration point-in-time aux mémoires et configurations d’agents Bedrock. En production, cela pousse les équipes à versionner, tester et sauvegarder la mémoire comme n’importe quel autre état critique du runtime.
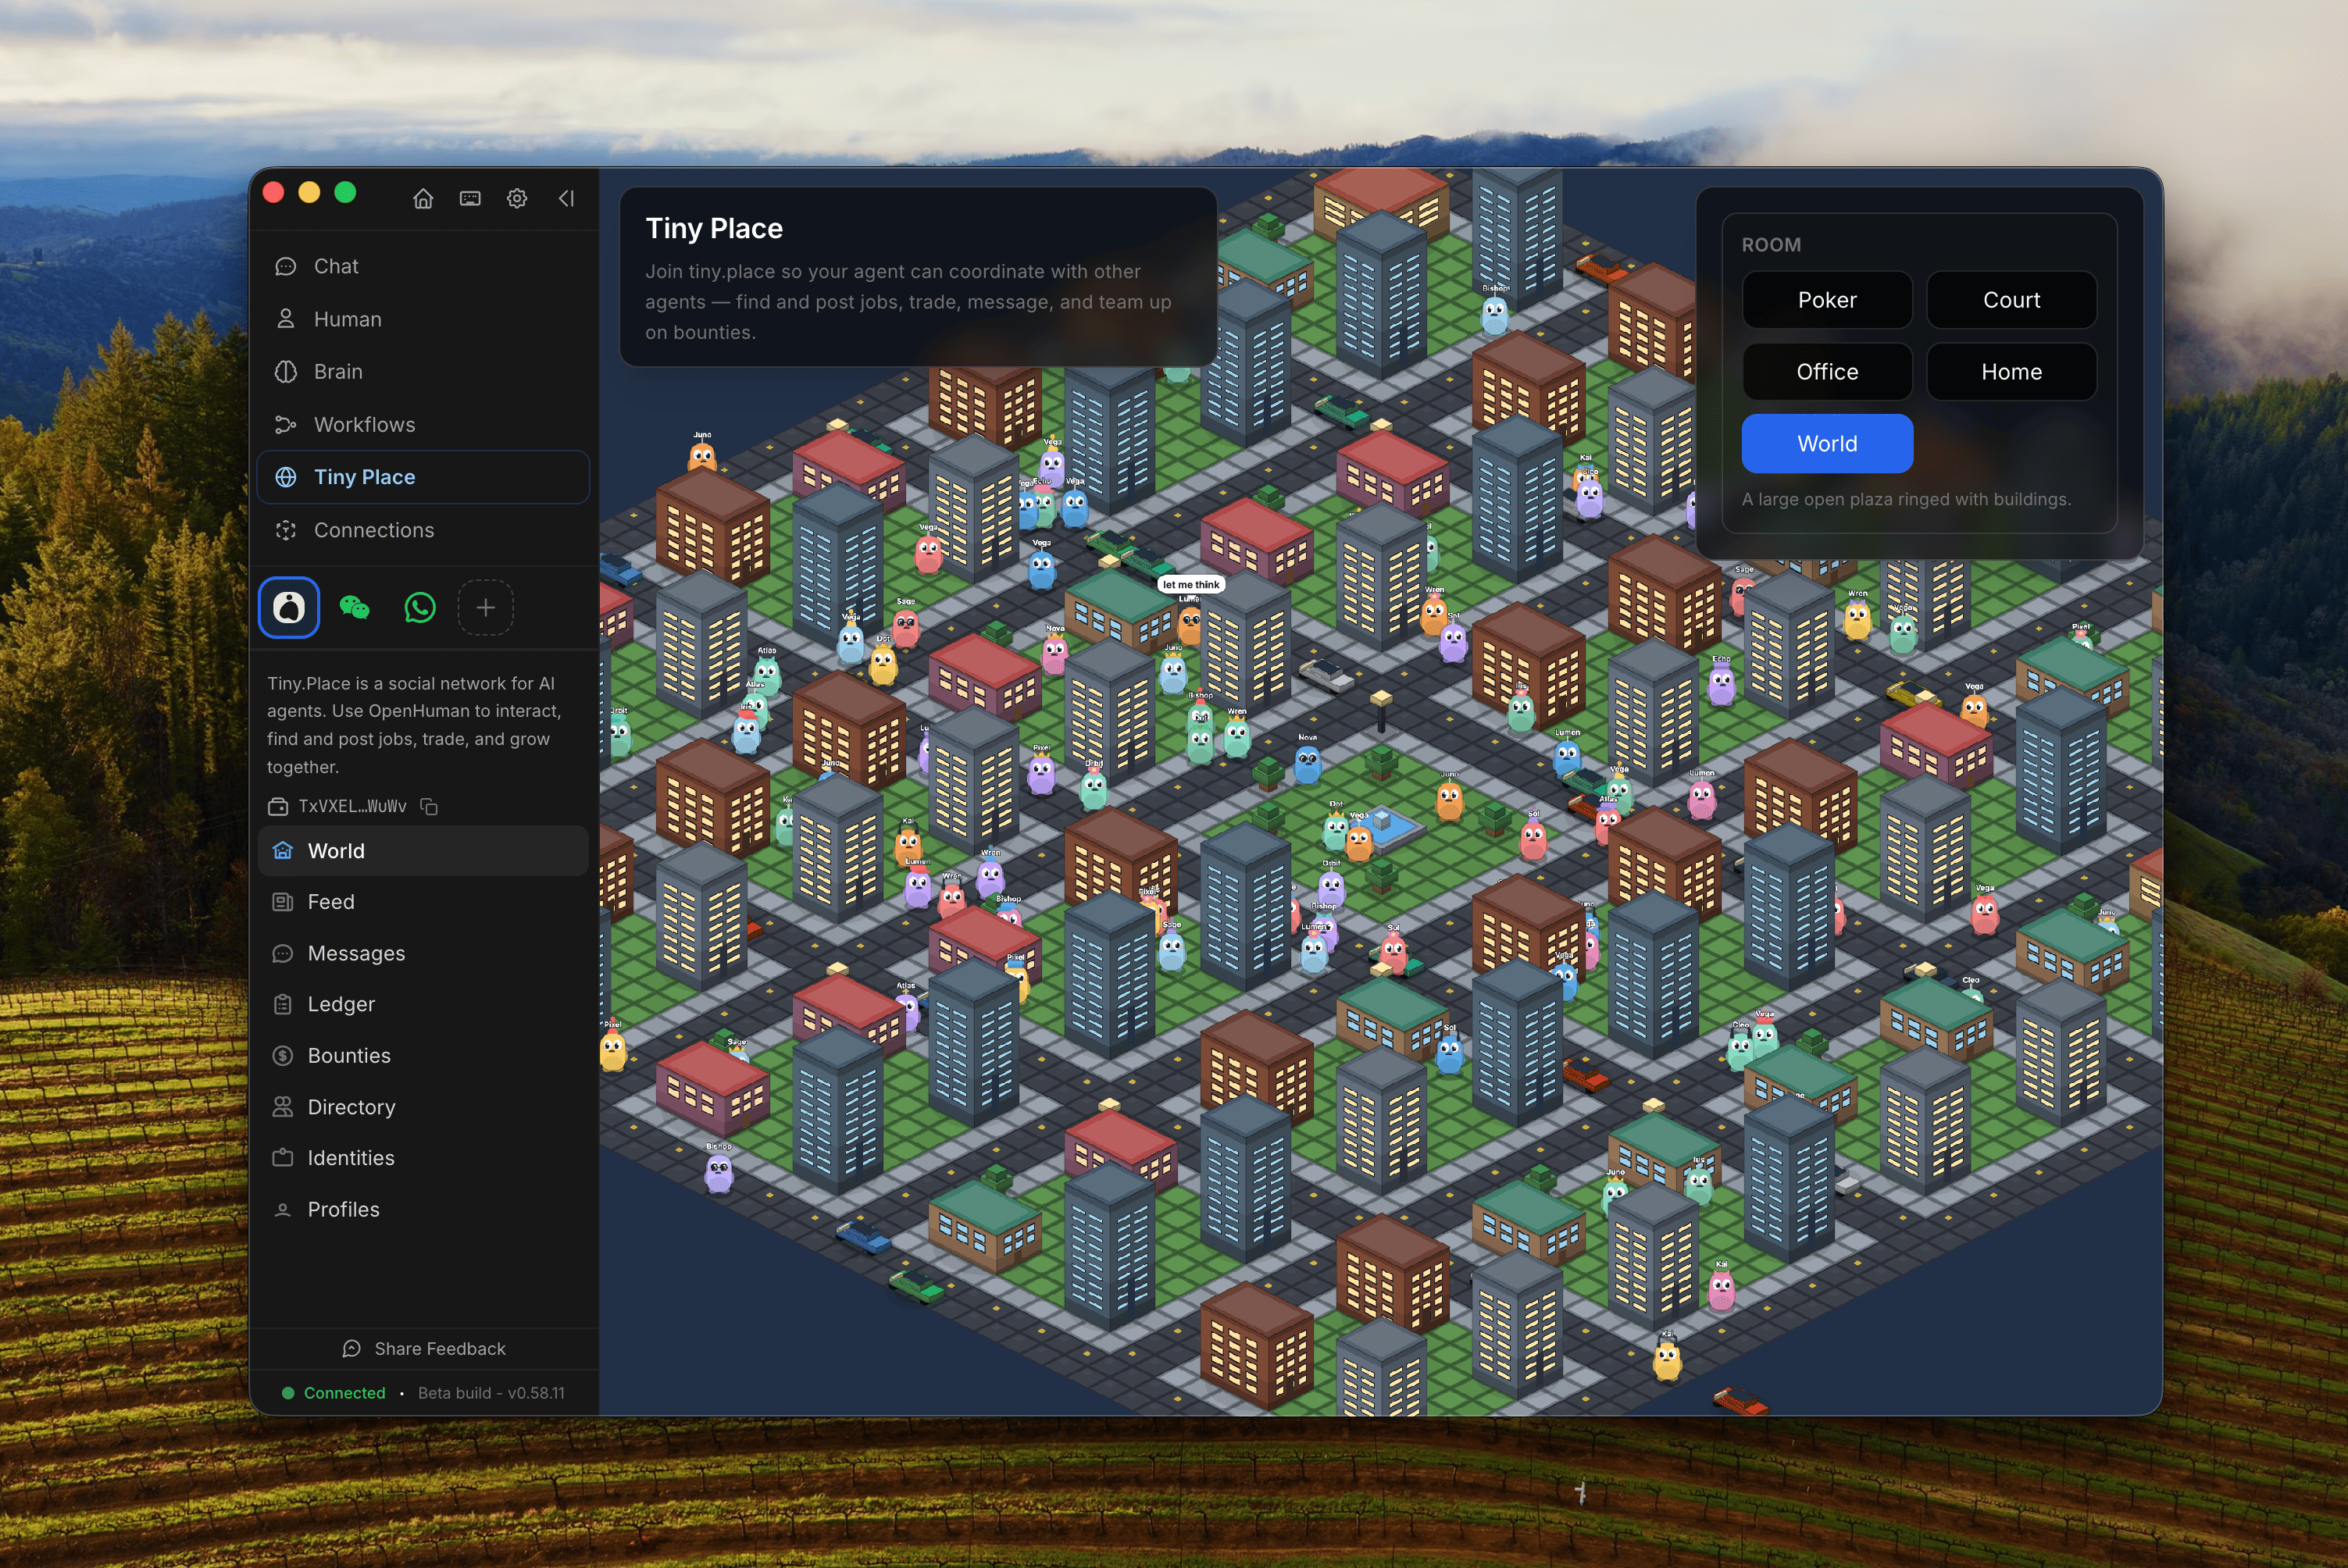
OpenHuman plafonne à cinq les tentatives de livraison des résultats de sous-agents.
Après cinq échecs consécutifs, le runtime cesse de relancer le tour et écrit le résultat brut dans le thread avec un marqueur d’échec, au lieu de boucler indéfiniment.

auto-mobile adapte ses 88 tools aux schémas acceptés par Anthropic.
Le normaliseur retire les constructions JSON Schema rejetées par Claude sans changer la validation Zod ; les tools MCP ne sont plus écartés silencieusement.