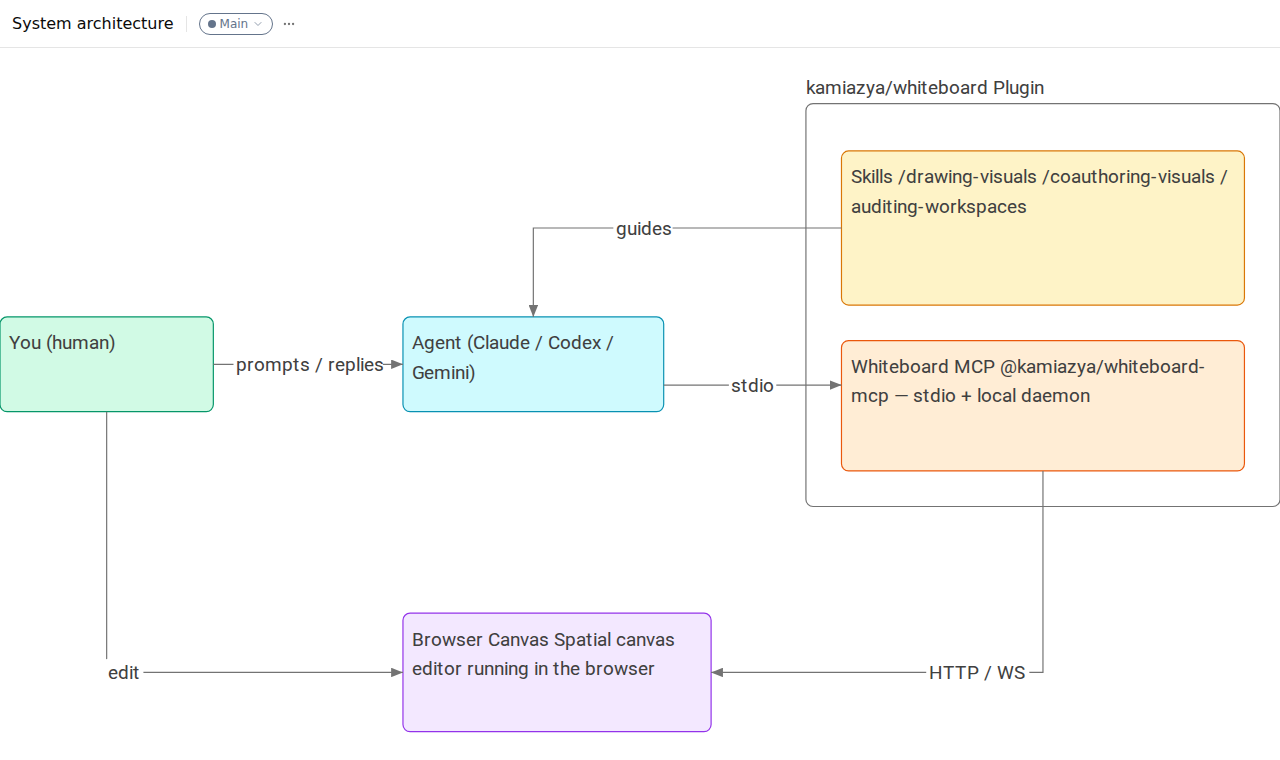
Whiteboard isole `pnpm dev` du daemon MCP installé.
Le script de développement passe par un wrapper qui utilise `.dev-data`, un port dérivé, ses propres origines et son token ; il n’écrit plus dans le vrai `~/.whiteboard` du développeur.
Whiteboard isole `pnpm dev` du daemon MCP installé.
Le script de développement passe par un wrapper qui utilise `.dev-data`, un port dérivé, ses propres origines et son token ; il n’écrit plus dans le vrai `~/.whiteboard` du développeur.
Strands matérialise l’agent harness comme un composant indépendant du modèle : le même runtime peut tourner localement ou chez plusieurs fournisseurs, avec mémoire, helper agent, tools et compaction intégrés. AWS attribue l’essentiel de son économie de tokens à ces choix de contexte, ce qui déplace une partie de la performance hors du LLM lui-même.
Google suit une logique différente mais convergente avec Antigravity : l’API expose un agent géré qui exécute du code, conserve des fichiers, compacte le contexte et branche des serveurs MCP dans une sandbox Linux. Le modèle sous-jacent reste configurable ; l’agent harness de l’IDE devient ainsi une primitive accessible par API.
Vercel pousse l’abstraction jusqu’au remplacement de l’agent harness : `HarnessAgent` peut piloter Claude Code, Codex, Cursor, Copilot ou OpenCode derrière la même interface, tandis que les abonnements OAuth restent sur l’hôte. Pour les développeurs, le choix d’un agent devient plus réversible, mais contexte, permissions, sandbox et secrets restent les vraies dépendances d’architecture.
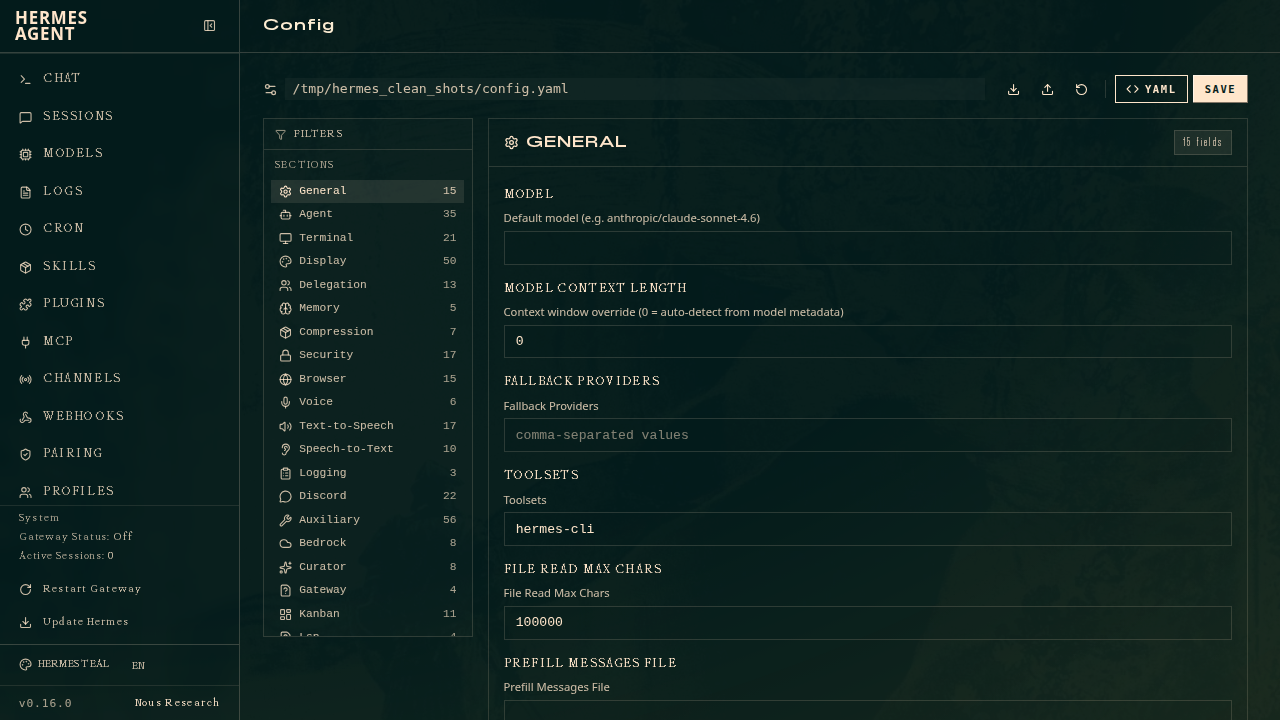
Hermes Agent restaure le partage OAuth entre ses profils nommés.
Les bots relisent le grant racine OpenAI Codex et y réécrivent les refresh tokens, évitant de refaire l’authentification pour chaque profil après rotation.
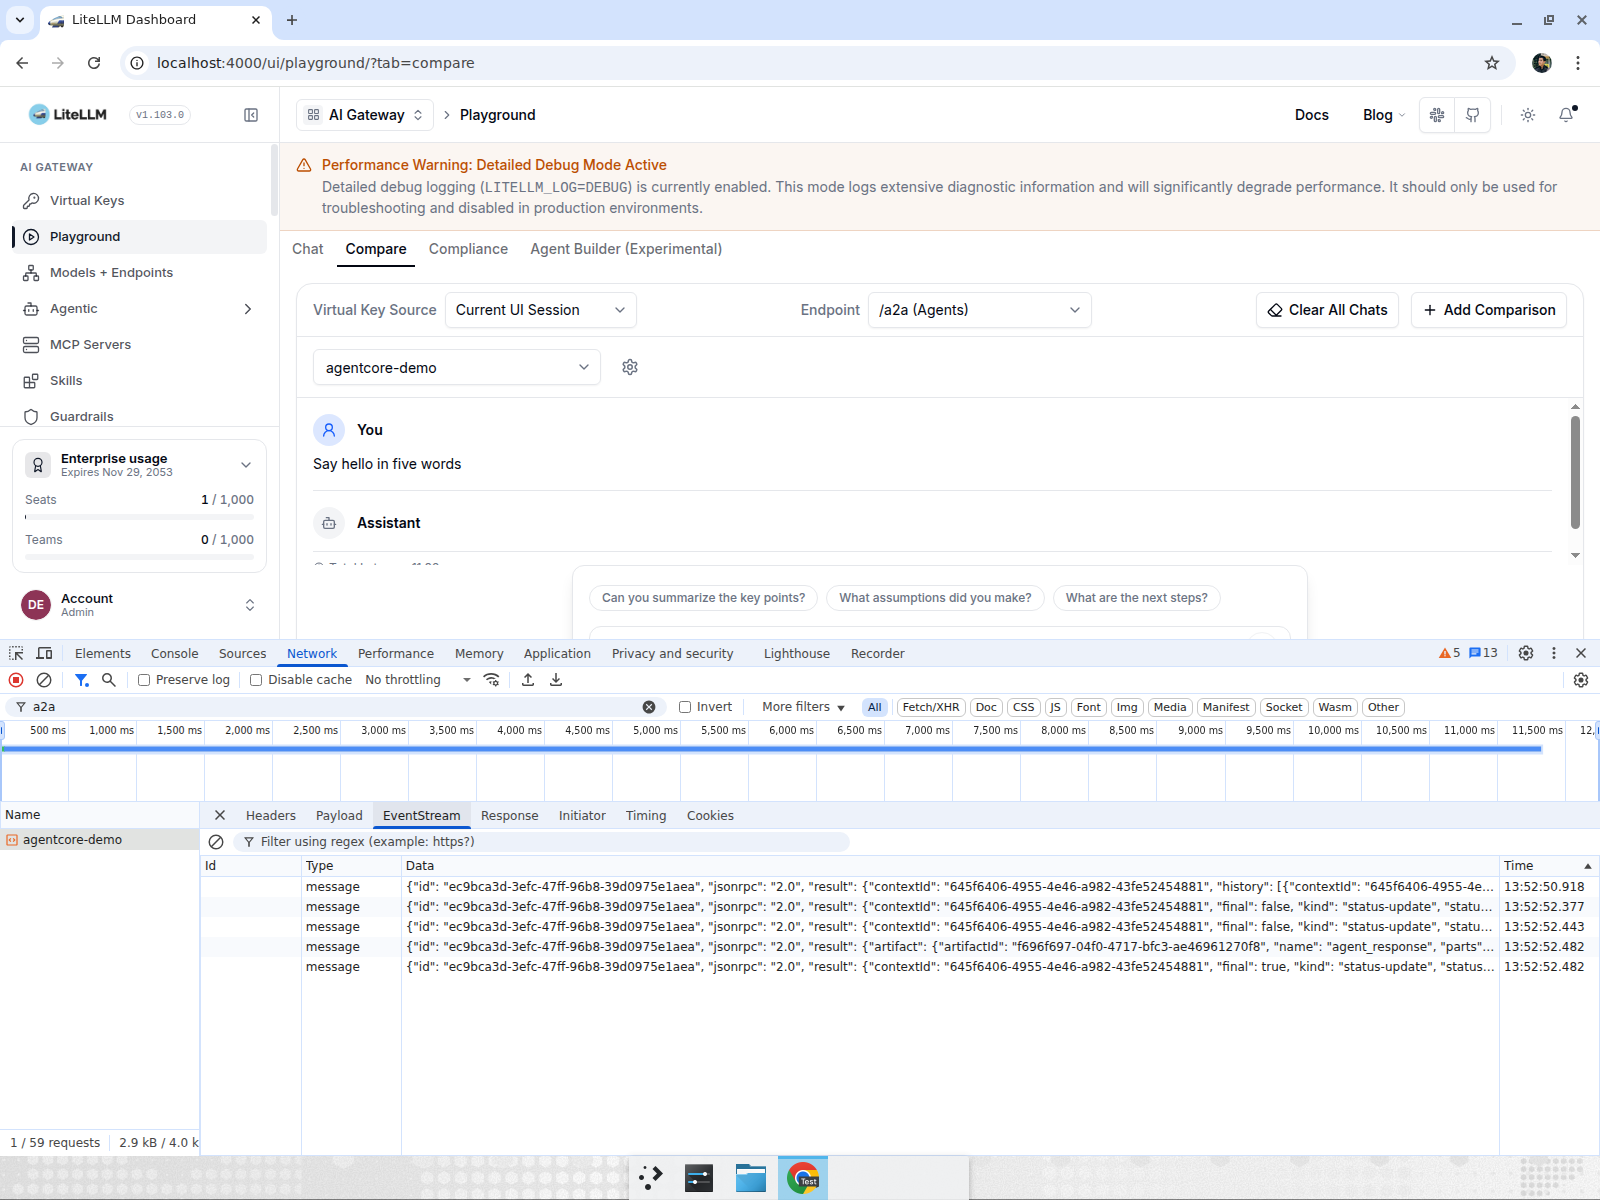
LiteLLM rétablit le streaming des agents Bedrock AgentCore via A2A.
Le proxy envoie désormais `message/stream` en amont : les événements SSE arrivent au fil du tour au lieu d’un unique résultat final.
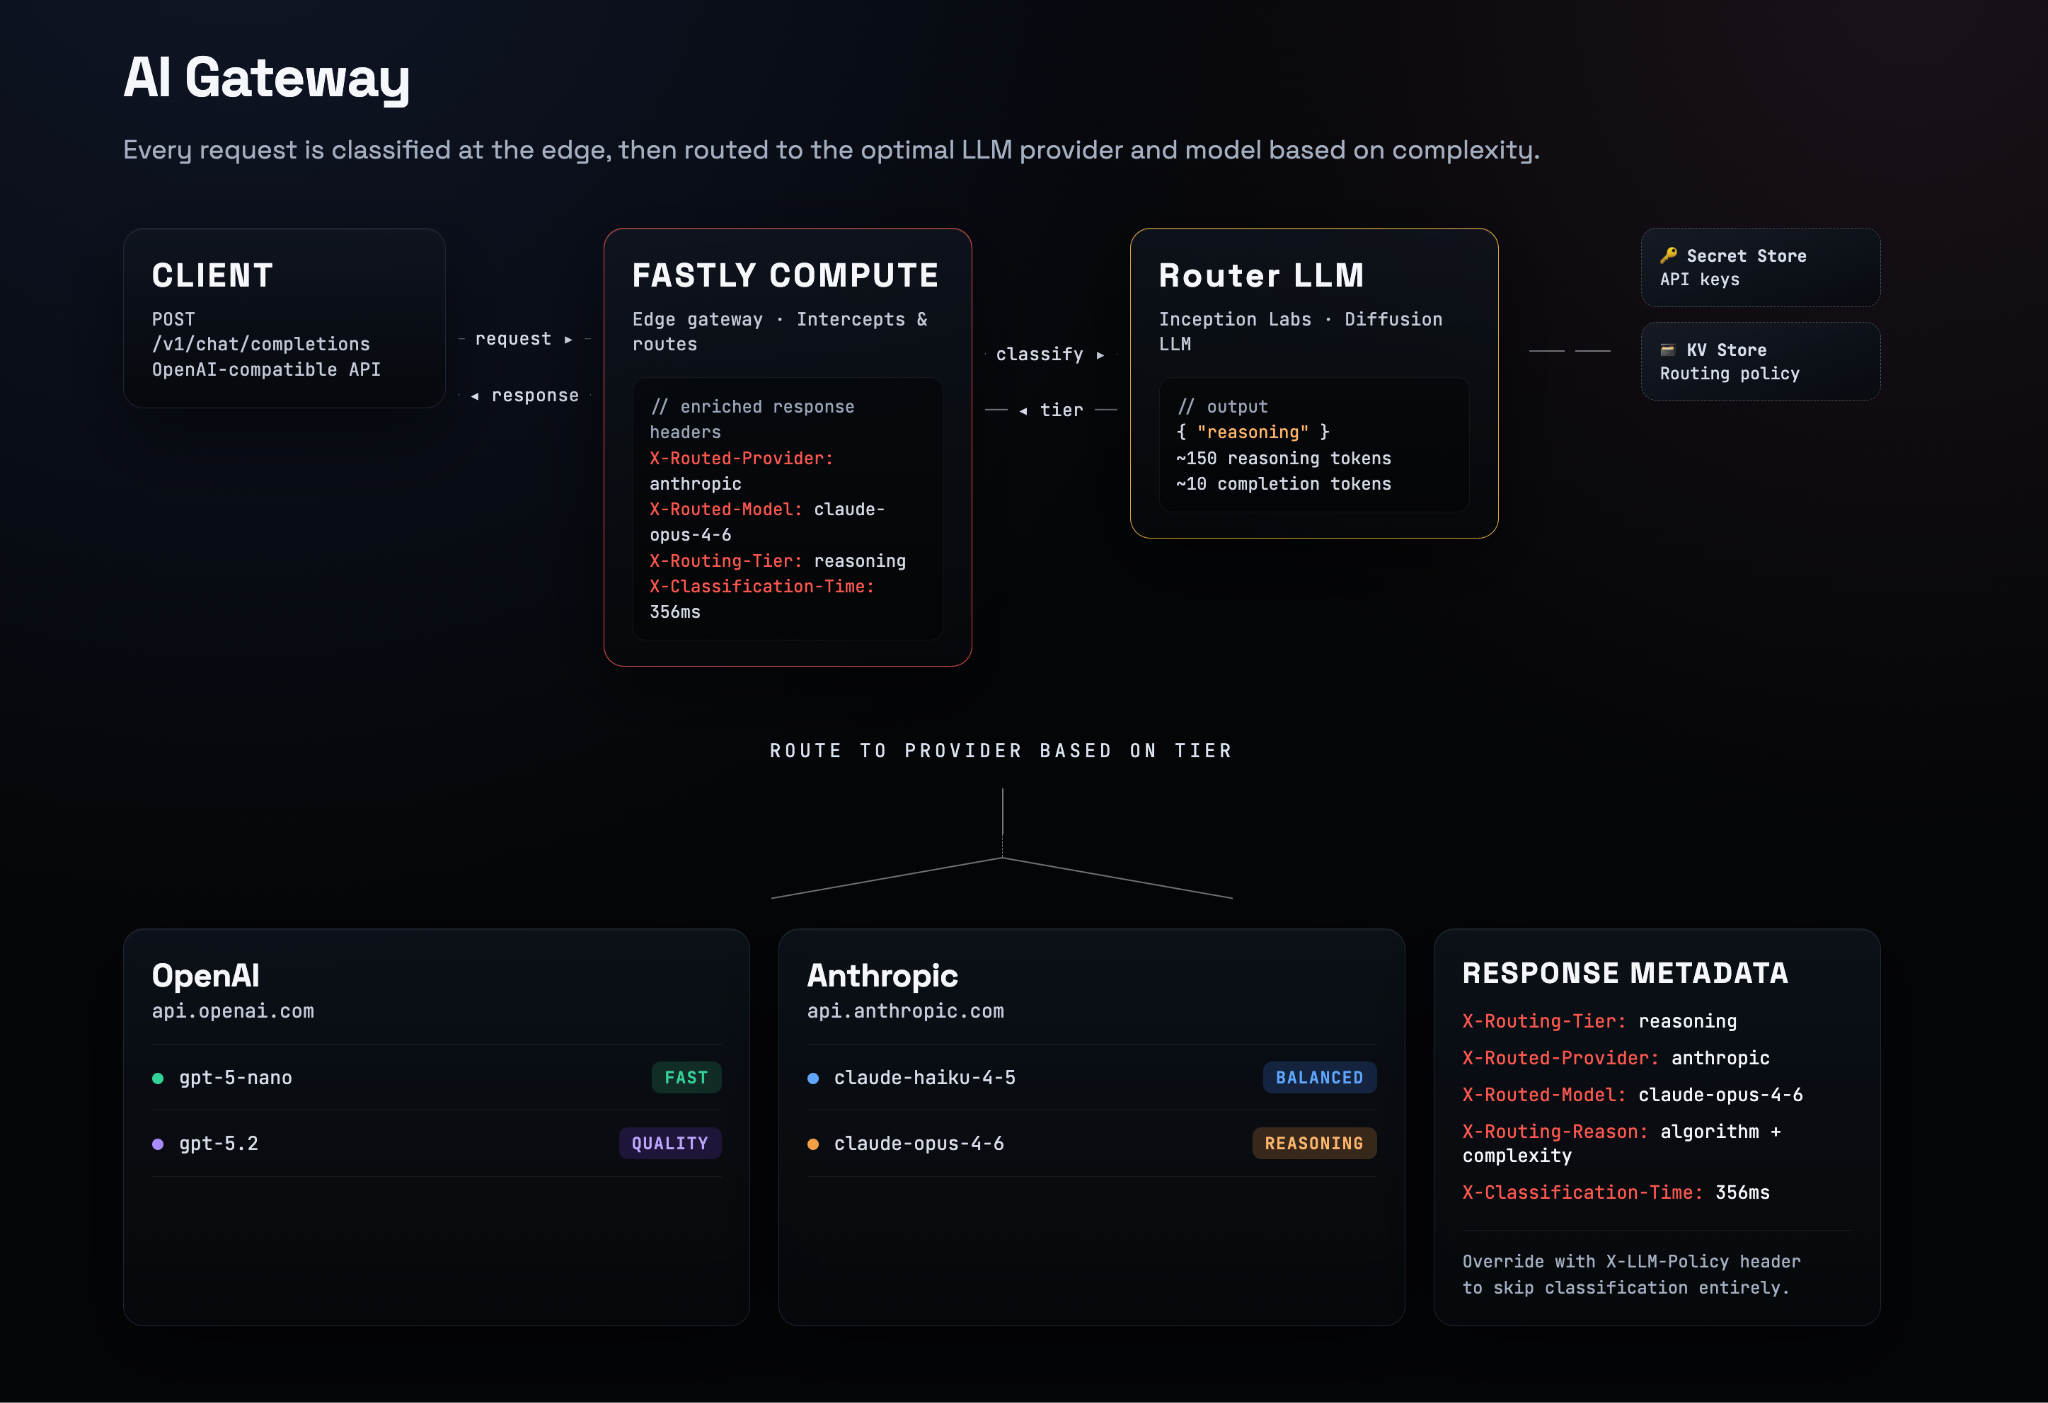
Fastly place un contrôle runtime devant les modèles et les API appelées par les agents.
AI Runtime Control centralise routage, clés virtuelles, budgets et failover ; API Security peut bloquer les appels d’agents hors contrat.

L’évaluation ne porte plus seulement sur un modèle isolé : MLPerf Inference 6.1 ajoute un benchmark Edge Agentic qui rejoue des trajectoires multi-tour de coding et un test RAG de bout en bout. Sur Jetson AGX Thor, NVIDIA montre que ce format révèle aussi les optimisations de runtime, avec 96 % des tokens de prompt servis depuis le cache.
Android Bench 2.0 déplace aussi l’évaluation vers des tâches de plusieurs jours : migrations, nouvelles fonctions, applications complètes et portages. Google abandonne le simple succès binaire au profit d’un taux d’achèvement continu ; le meilleur pass rate sur ces tâches longues tombe autour de 28 %, malgré des scores proches de 91 % sur les anciennes tâches.
EnvHarness pousse la logique un cran plus loin : l’environnement lui-même s’adapte aux faiblesses observées sans modifier le dépôt ni son vérificateur. Le framework change états initiaux, observations ou règles externes, puis valide que la tâche reste solvable. Pour les développeurs, benchmark, harness et environnement deviennent donc des composants versionnés du workflow d’évaluation.

OpenClaw garde l’expansion et le retour à la ligne des blocs de code pendant le streaming.
La fermeture d’un bloc Markdown ne recrée plus son DOM pendant la réponse ; les réglages du lecteur restent actifs quand les paragraphes suivants arrivent.
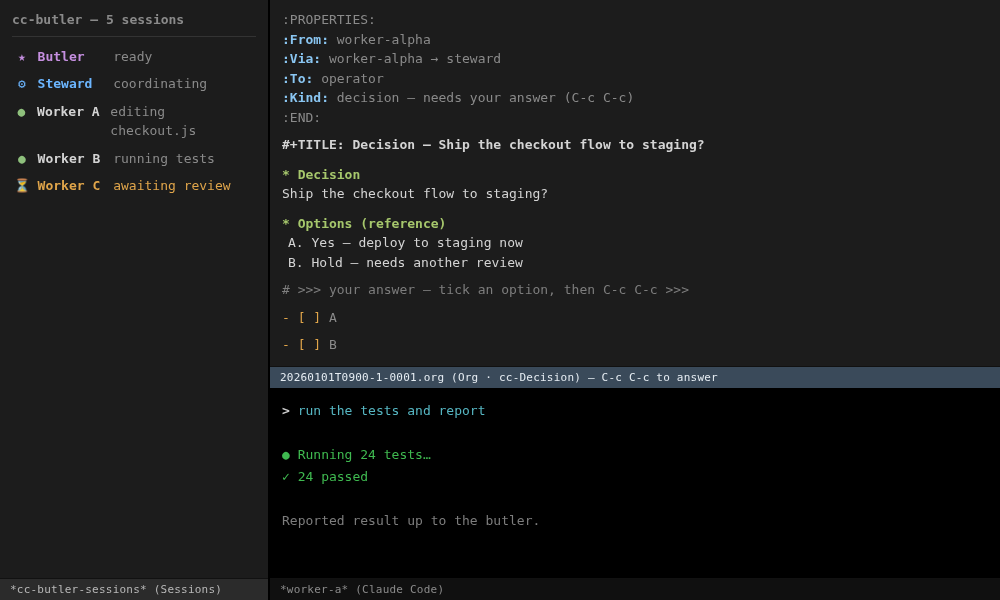
cc-butler relance Claude Code après une compaction réussie.
Le driver vérifie que le champ de saisie est vide et qu’aucun dialogue ne bloque, puis renvoie une consigne de reprise ; les sessions n’attendent plus un message humain après /compact.
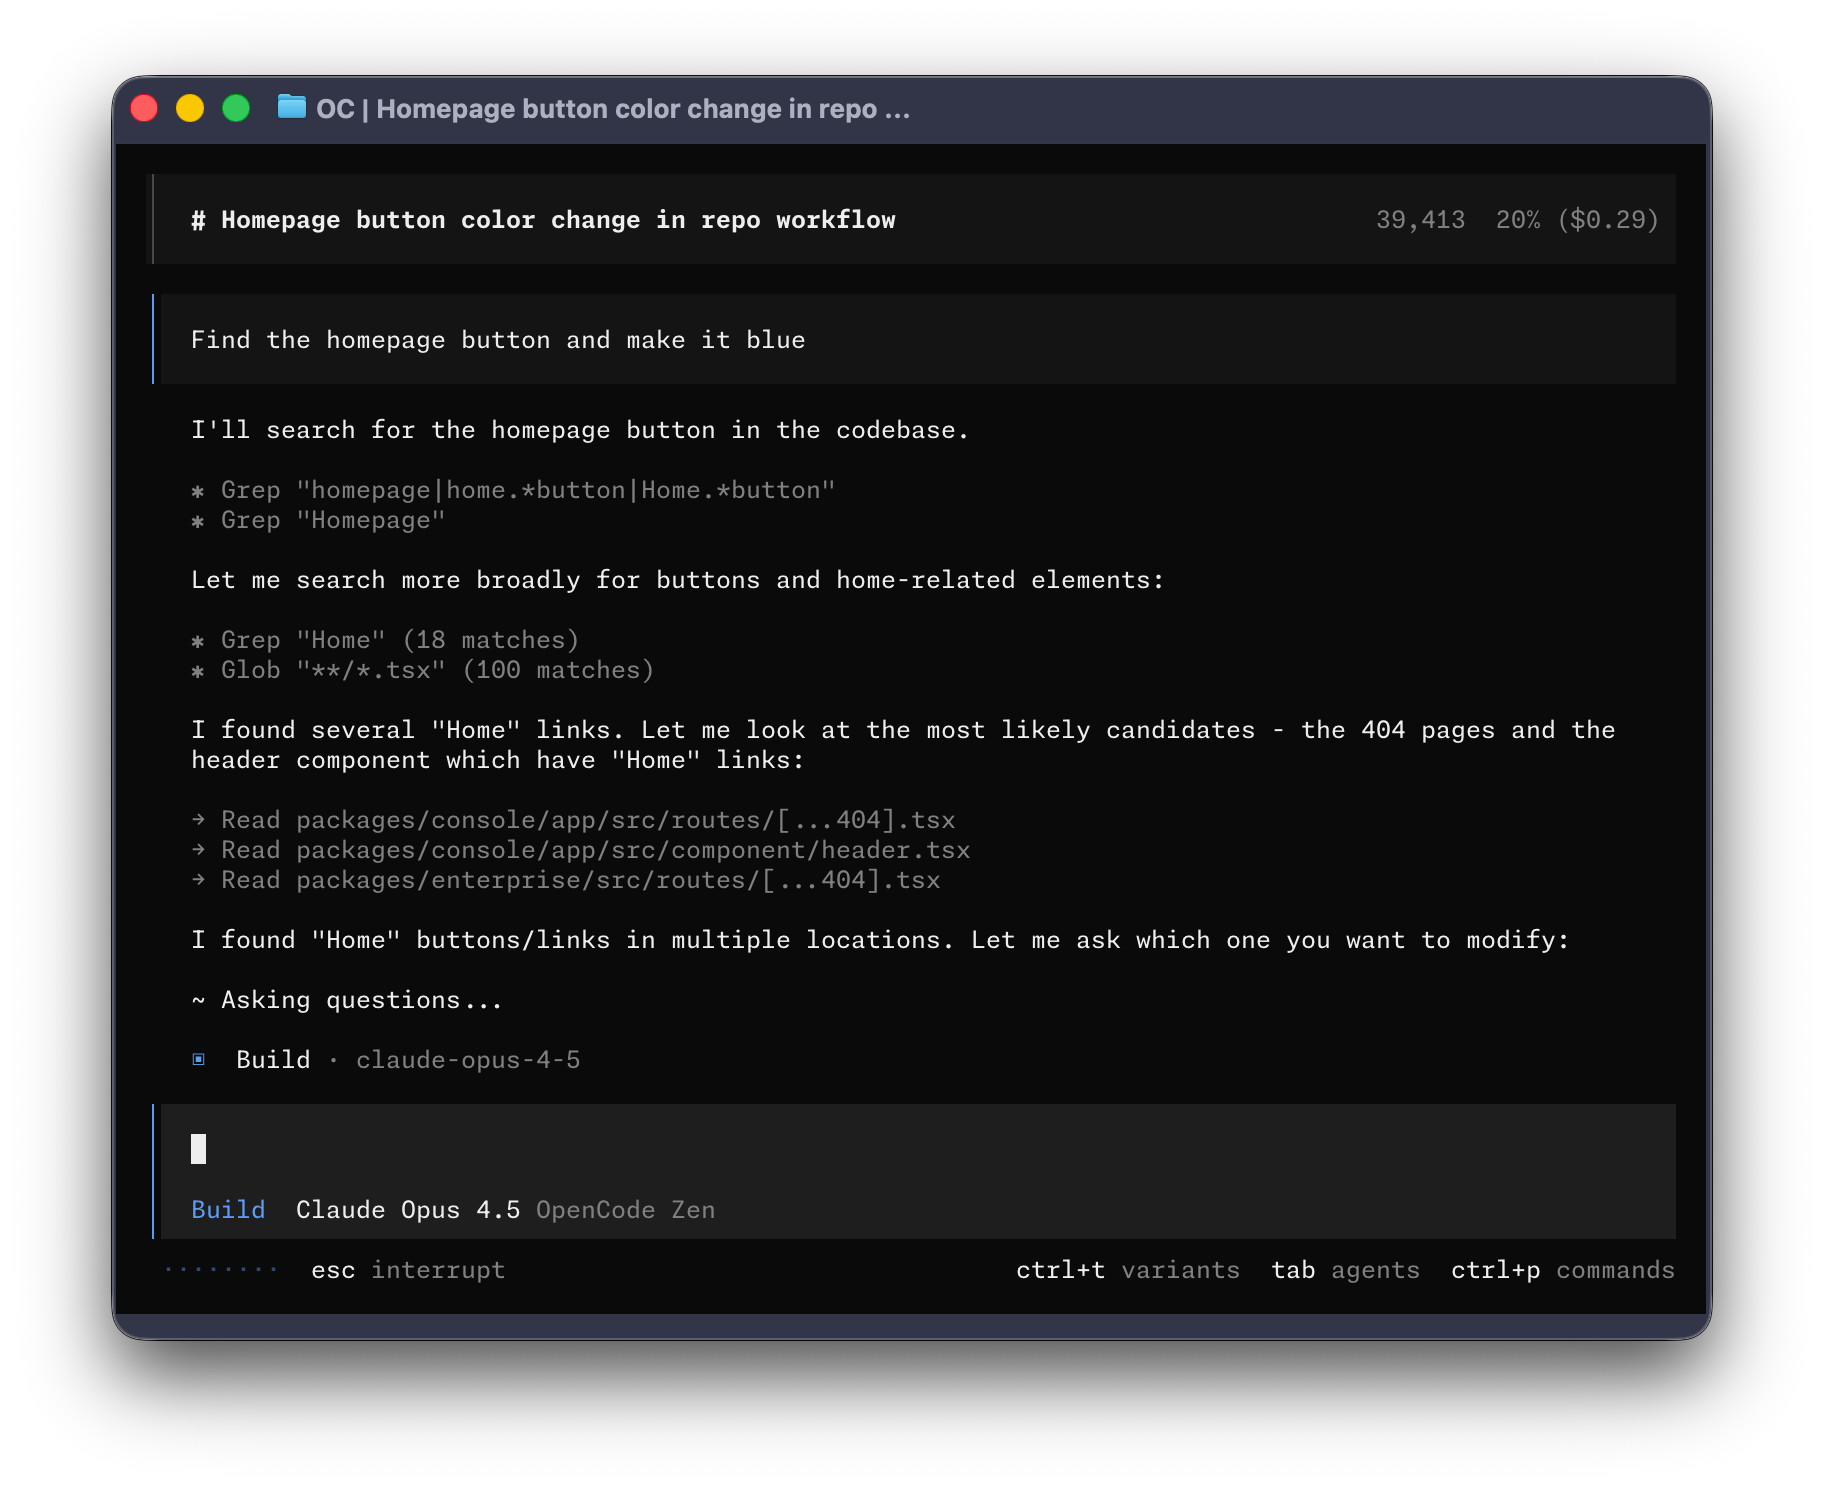
CoForge ajoute OpenCode comme runtime de coding agent dans son daemon.
Le daemon lance désormais `opencode run --format json`, reprend les sessions et mappe les tools ; OpenCode rejoint ainsi le même workflow d’exécution que les autres agents.
Supabase traite désormais la connaissance produit comme une extension installable du coding agent : son plugin réunit MCP et skills pour requêtes SQL, migrations, Edge Functions et bonnes pratiques Postgres. Une seule commande détecte les agents présents. La documentation n’est plus seulement consultée ; elle devient une couche procédurale chargée à la demande.
AWS montre pourquoi cette couche compte en production. Sans skills, Kiro et Claude Code ont choisi TGI pour déployer Qwen3 sur SageMaker, provoquant plusieurs échecs facturés. Les six skills Hugging Face encodent le choix du conteneur, l’IAM, l’autoscaling, les alarmes et le teardown ; AWS préfère ces fichiers éditables à l’attente d’un modèle réentraîné.
Unity adopte la même logique avec 31 skills Codex maintenus par les équipes du moteur, conçus pour utiliser l’API actuelle et vérifier le résultat plutôt que moyenner des années de tutoriels. Alors que 42 % des développeurs interrogés par BairesDev disent déjà laisser l’IA écrire au moins la moitié de leur code, le savoir fournisseur devient un composant versionné du workflow.
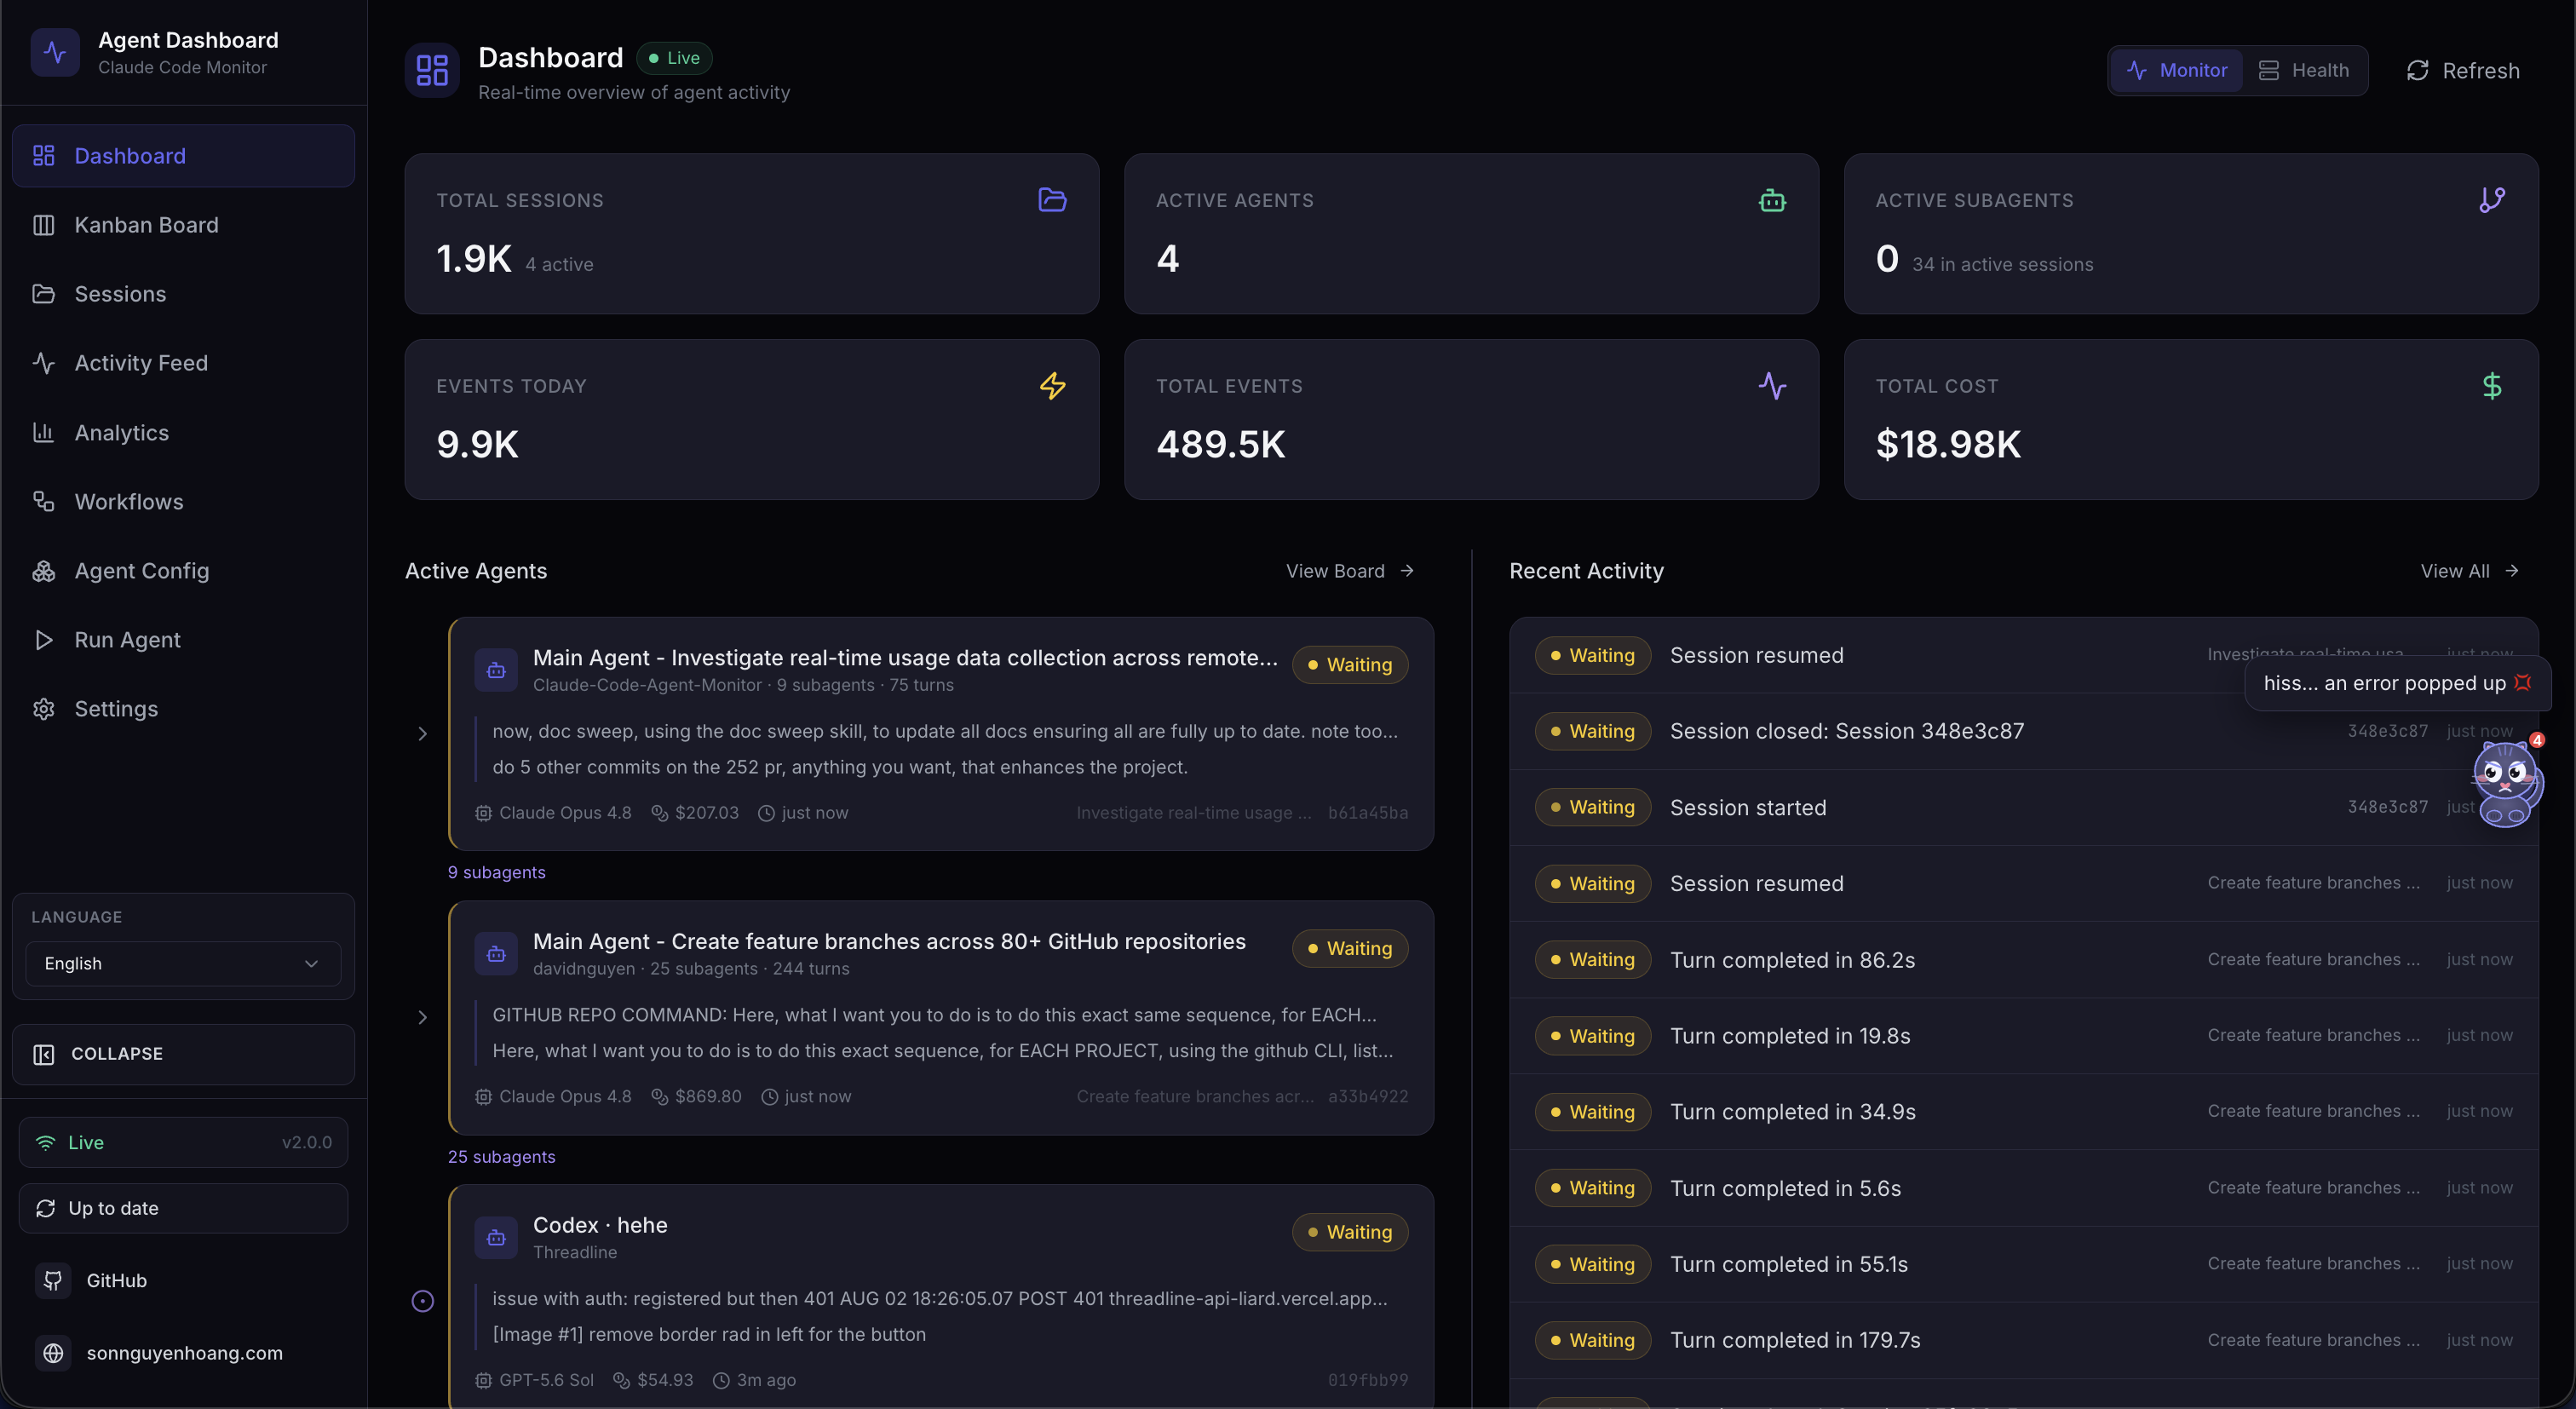
Claude Code Agent Monitor cesse de compter les agents sans statut comme disponibles.
Le nouvel état `unreported` sépare une disponibilité réellement observée d’un agent jamais signalé, pour éviter de lui attribuer du travail sur une disponibilité supposée.
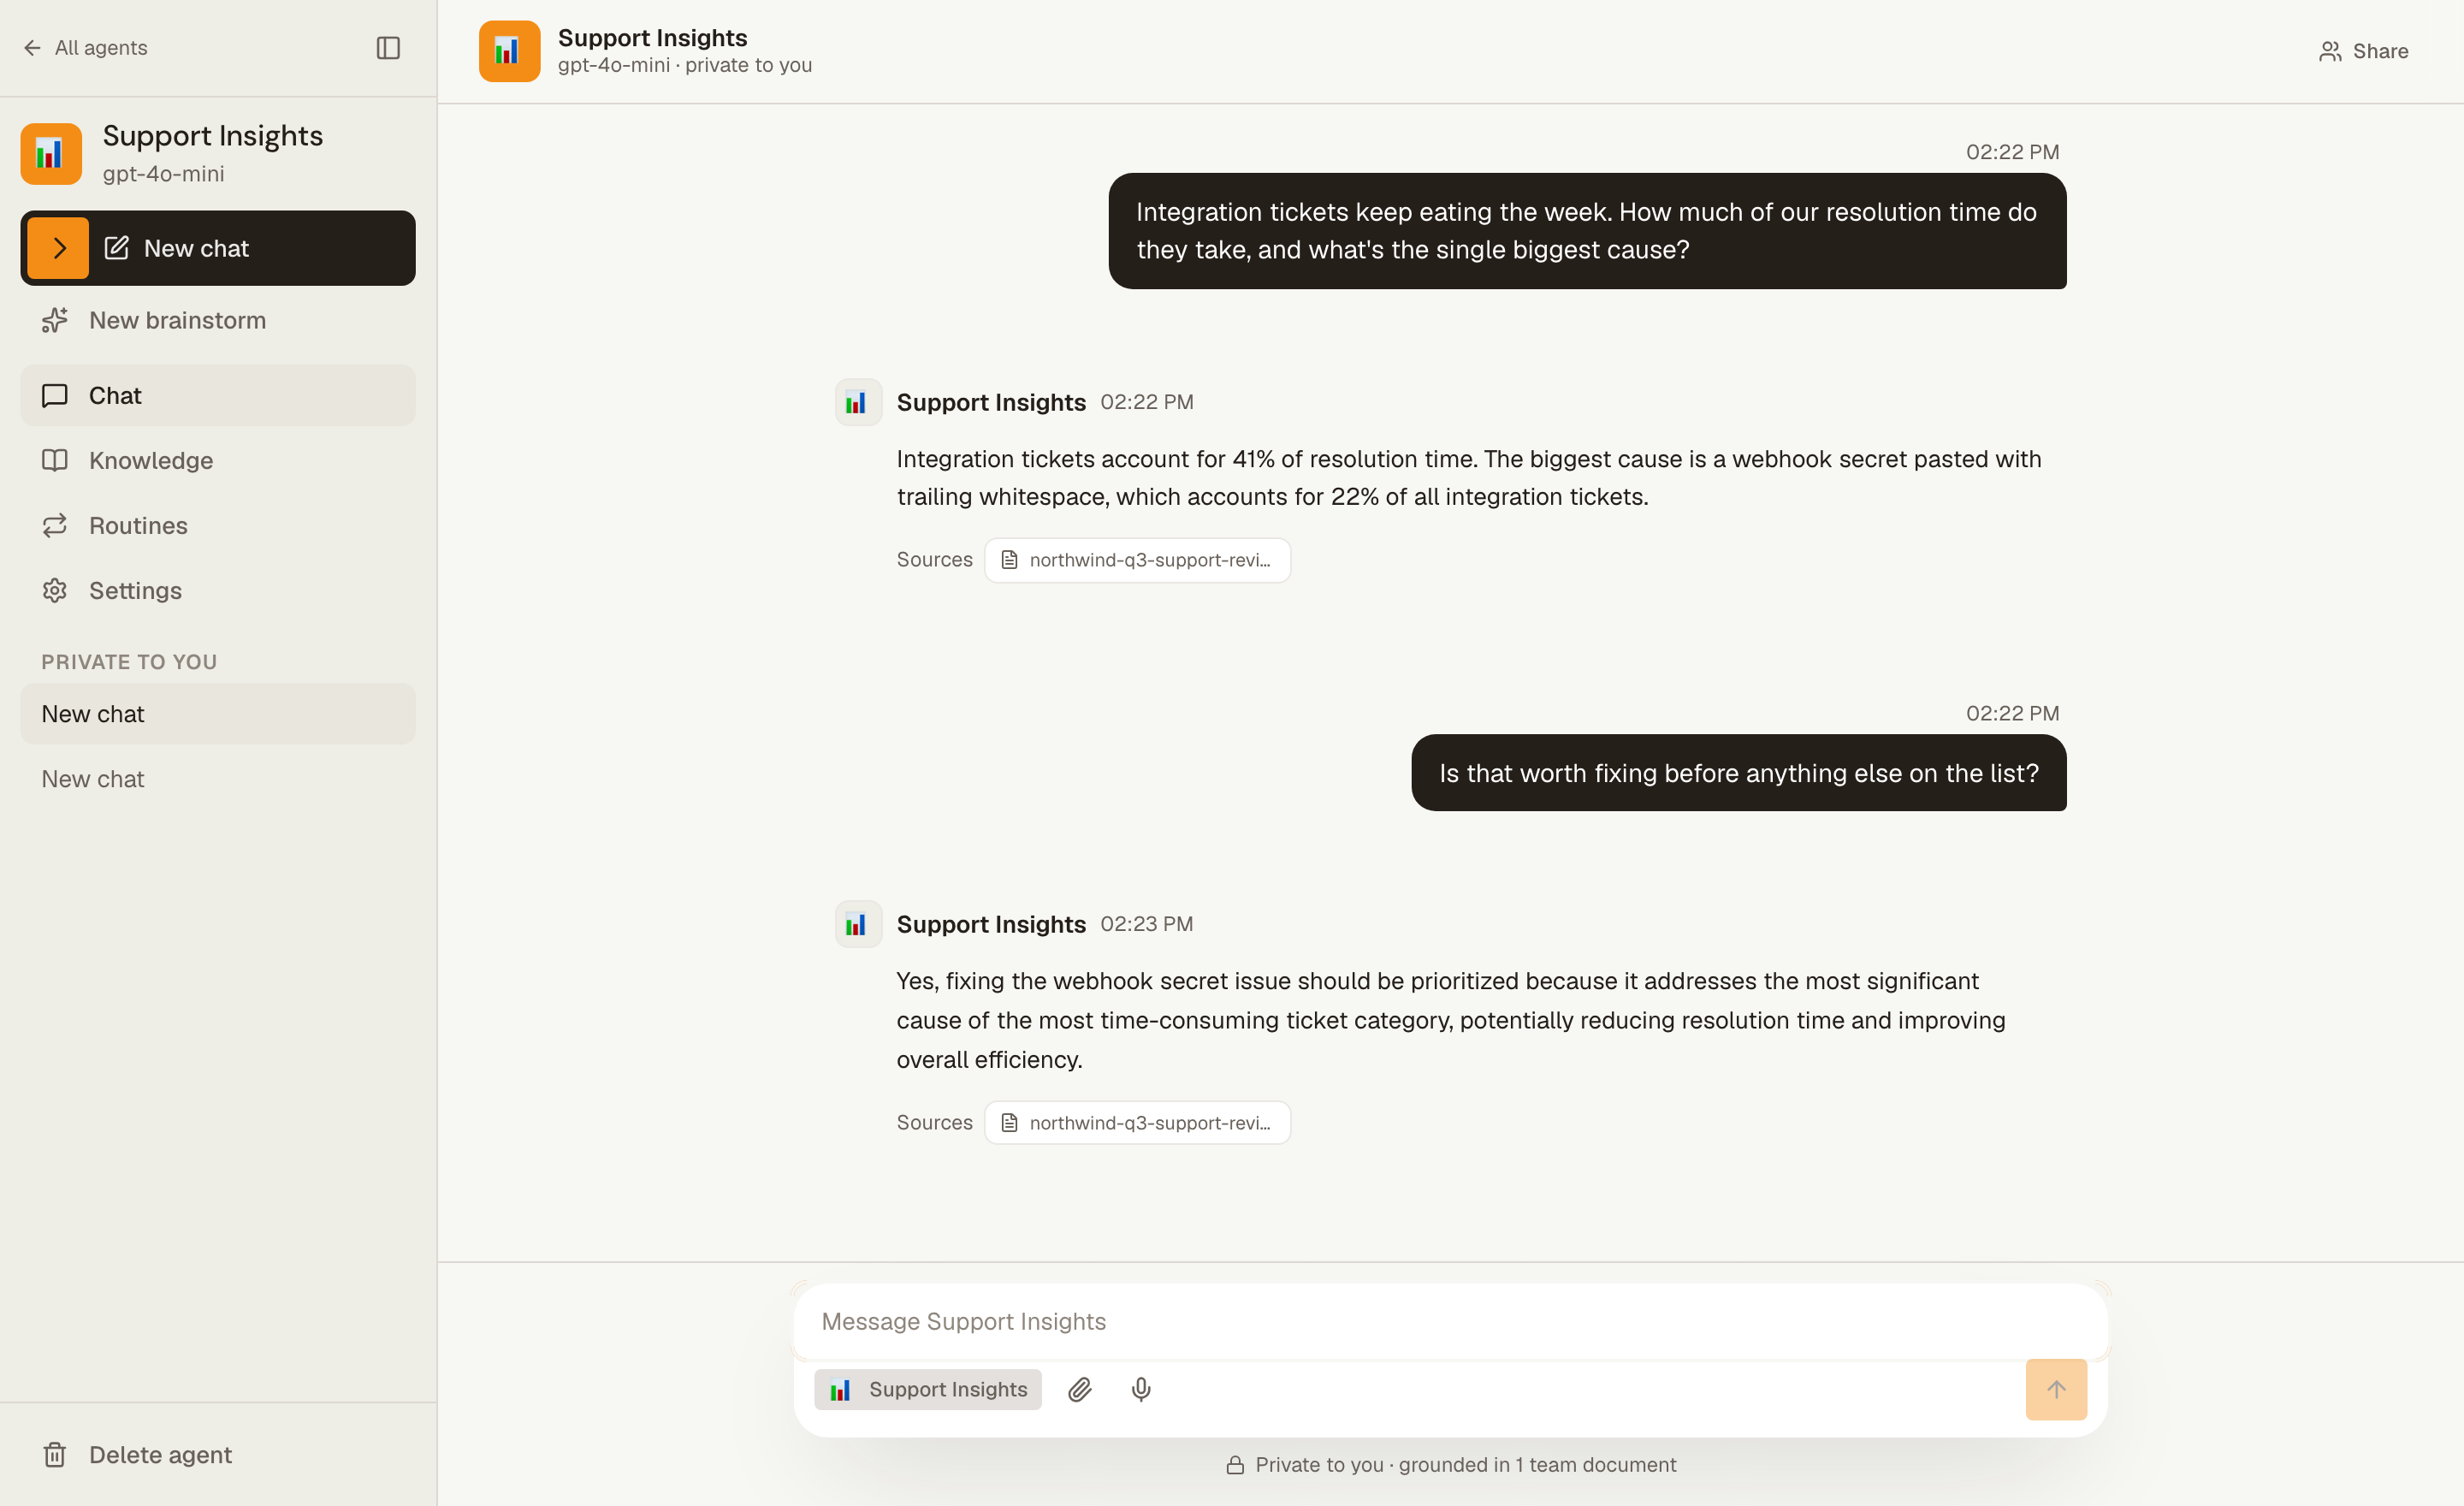
Covan donne six tools à son agent et suspend les actions qui exigent une confirmation.
L’agent peut enchaîner recherche, SQL, HTTP, email et planification ; un tool peut mettre le tour en pause avec `needs_confirmation`, puis reprendre après validation.