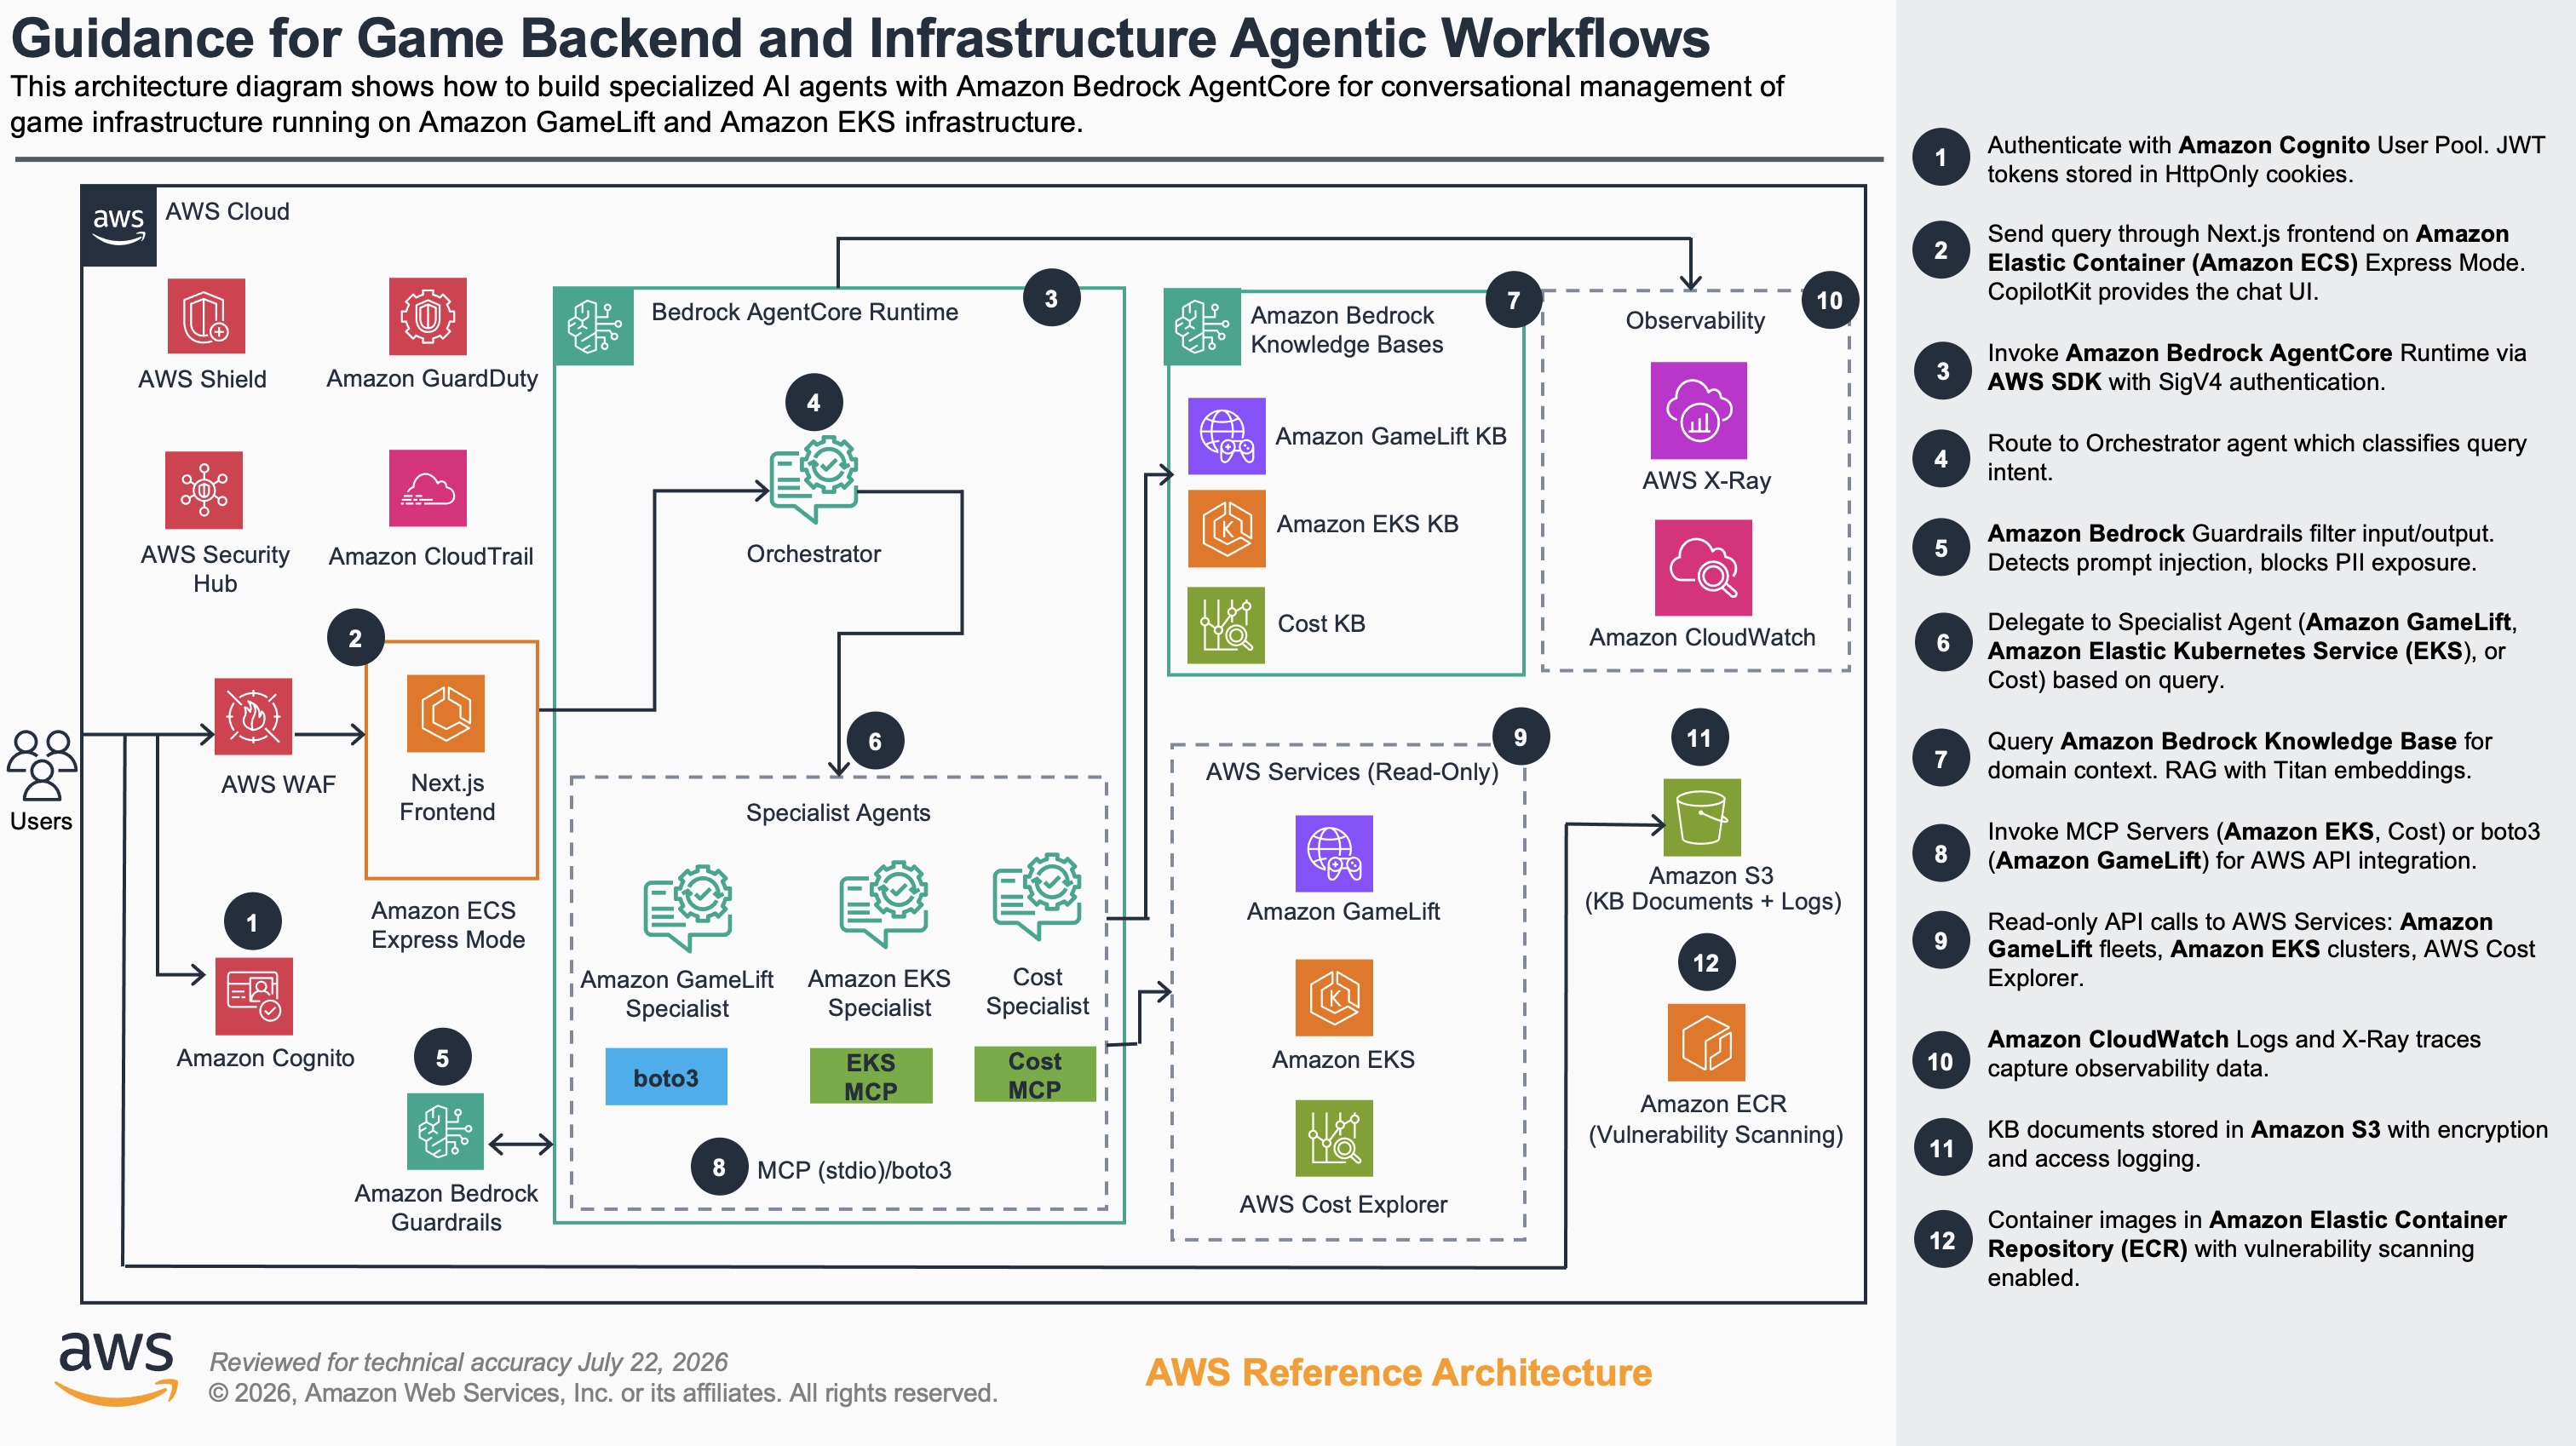
AWS AgentCore vérifie l’identité Cognito dans le runtime des agents.
Le sample AWS abandonne `runtimeUserId` : le runtime vérifie signature, expiration, client, groupes et scopes du JWT, et refuse l’identité fournie par le body.
AWS AgentCore vérifie l’identité Cognito dans le runtime des agents.
Le sample AWS abandonne `runtimeUserId` : le runtime vérifie signature, expiration, client, groupes et scopes du JWT, et refuse l’identité fournie par le body.

Le problème de sécurité des agents remonte désormais jusqu’au contrat avec le fournisseur de modèle. Reuters rapporte que Palantir exige une garantie irrévocable de zéro rétention avant d’activer les modèles Anthropic, tandis que Nvidia réserve Claude aux tâches moins sensibles. Pour les développeurs, classifier les workloads et leurs données devient une étape d’architecture.
Boomi matérialise cette séparation dans son runtime : un agent peut être placé dans un cloud privé ou on-premises, tandis que ses connecteurs MCP appliquent des accès contrôlés et permissionnés. Le choix du modèle ne détermine donc plus seul la frontière ; emplacement d’exécution, identité et politiques de connexion deviennent des paramètres distincts.
Runpod montre le même déplacement côté infrastructure. Son serveur MCP peut créer des Pods, déployer des endpoints et gérer des volumes avec la clé du compte ; l’éditeur recommande une clé dédiée à privilèges limités et des confirmations pour les opérations destructrices. Le secret et son périmètre deviennent le garde-fou dur de l’agent.
Agentex filtre la découverte d’agents par les métadonnées de leur AgentCard.
`GET /agents` accepte désormais `agent_card_metadata` pour ne retourner que les agents déclarant les capacités demandées, sans tout filtrer côté client.
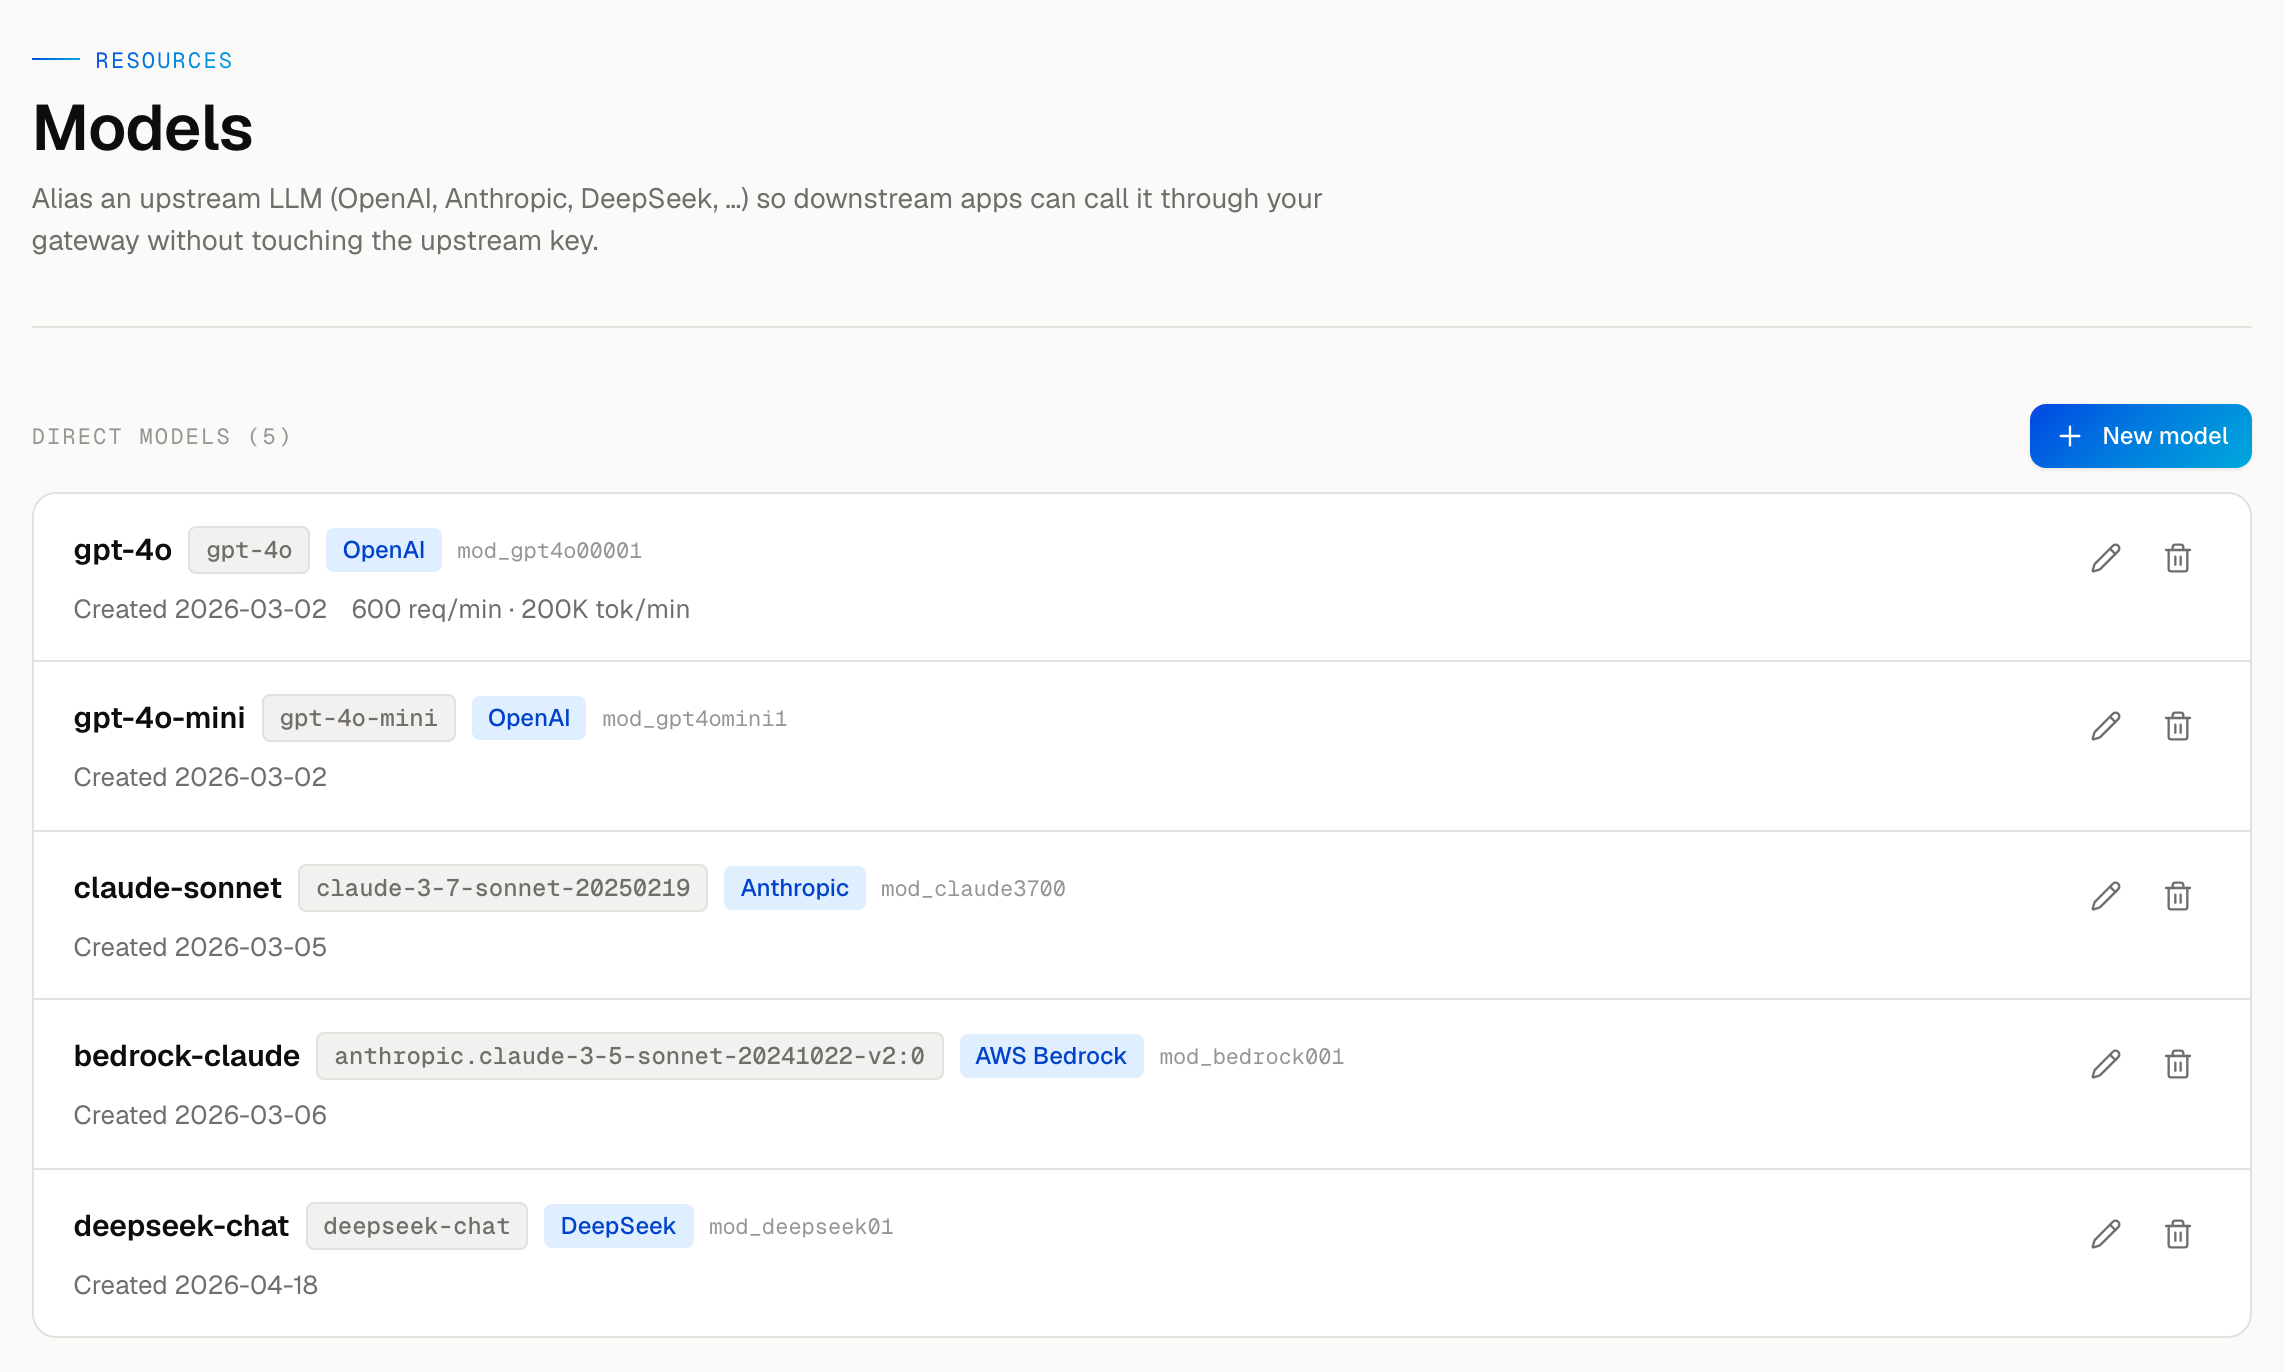
AISIX transmet les sorties JSON structurées à Anthropic, Gemini et Bedrock.
Le gateway mappe `response_format` vers les contrôles natifs de chaque provider et utilise un fallback par tool call quand le modèle ne peut pas contraindre directement son JSON.
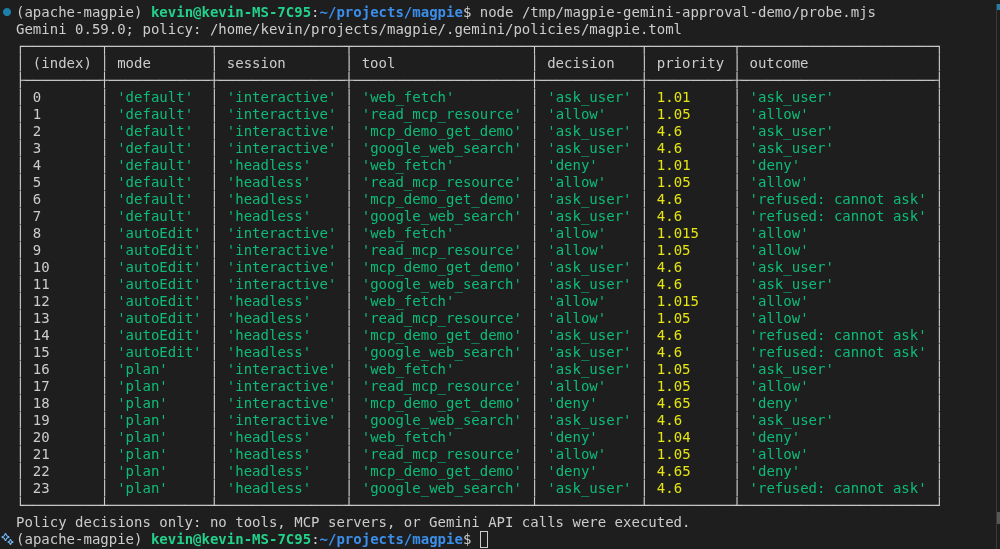
Magpie exige une approbation pour les lectures web et MCP de Gemini.
Magpie impose désormais une validation par appel à `web_fetch` et `read_mcp_resource`, y compris en auto-edit et Plan Mode ; les appels headless sont refusés.
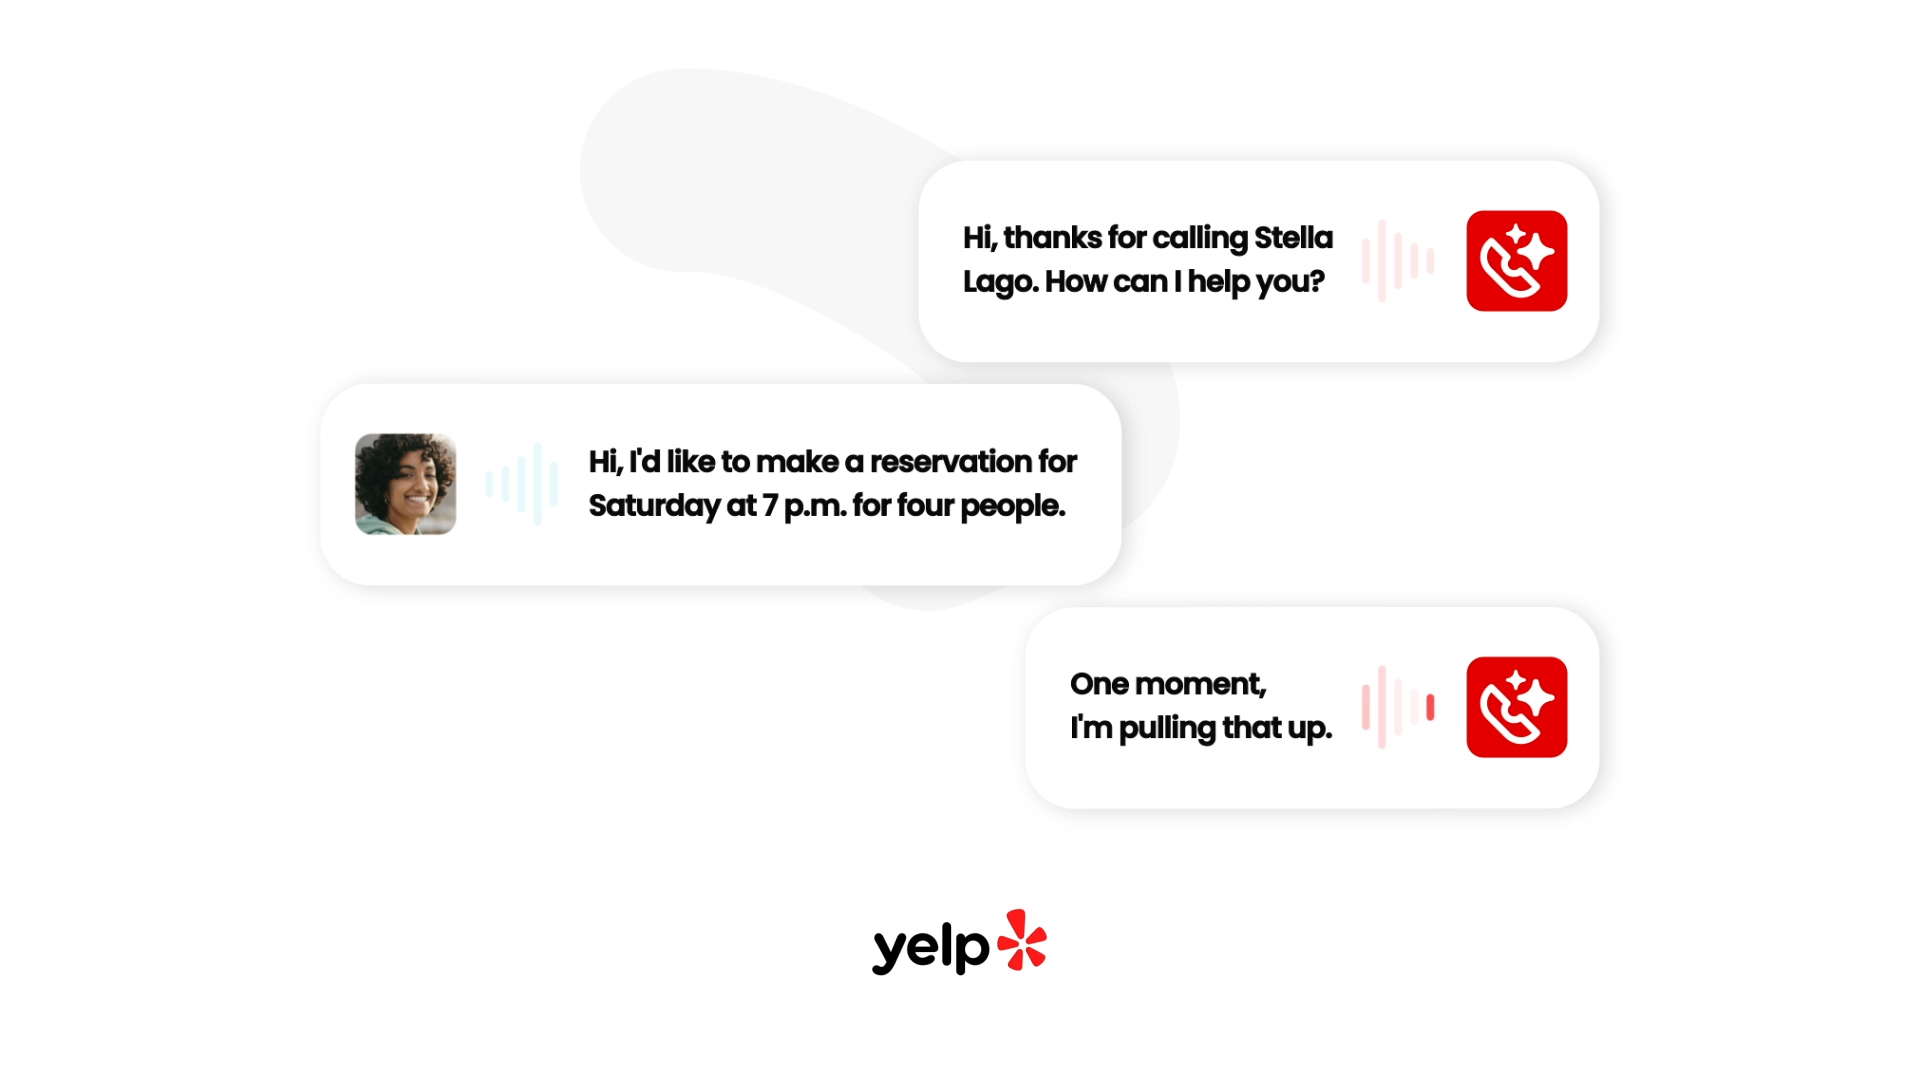
La boucle vocale devient un runtime distinct du travail de fond. Avec GPT‑Live‑1, écoute et parole fonctionnent en full-duplex, interruptions et silences restent dans la couche audio, puis raisonnement et tool calling sont délégués à un modèle backend. Les développeurs n’ont plus à orchestrer une chaîne STT‑LLM‑TTS pour chaque échange.
Yelp montre ce découpage en production : GPT‑Live‑1 sert de couche vocale frontale à Yelp Host et Hatch, tandis que les données métier gèrent disponibilités, règles de réservation et routage. L’entreprise observe davantage d’appels traités sans transfert et des phrases plus naturelles, signe que la voix peut évoluer sans réécrire l’intelligence opérationnelle.
Deepgram expose en parallèle des contrôles de session pour écouter, réfléchir, parler, interrompre ou modifier le prompt à chaud. Surtout, `defer_until_eot` retarde une action irréversible jusqu’à confirmation du tour utilisateur et annule l’appel si la personne reprend la parole. Le contrat de l’agent vocal devient donc : conversation spéculative, effets de bord confirmés.
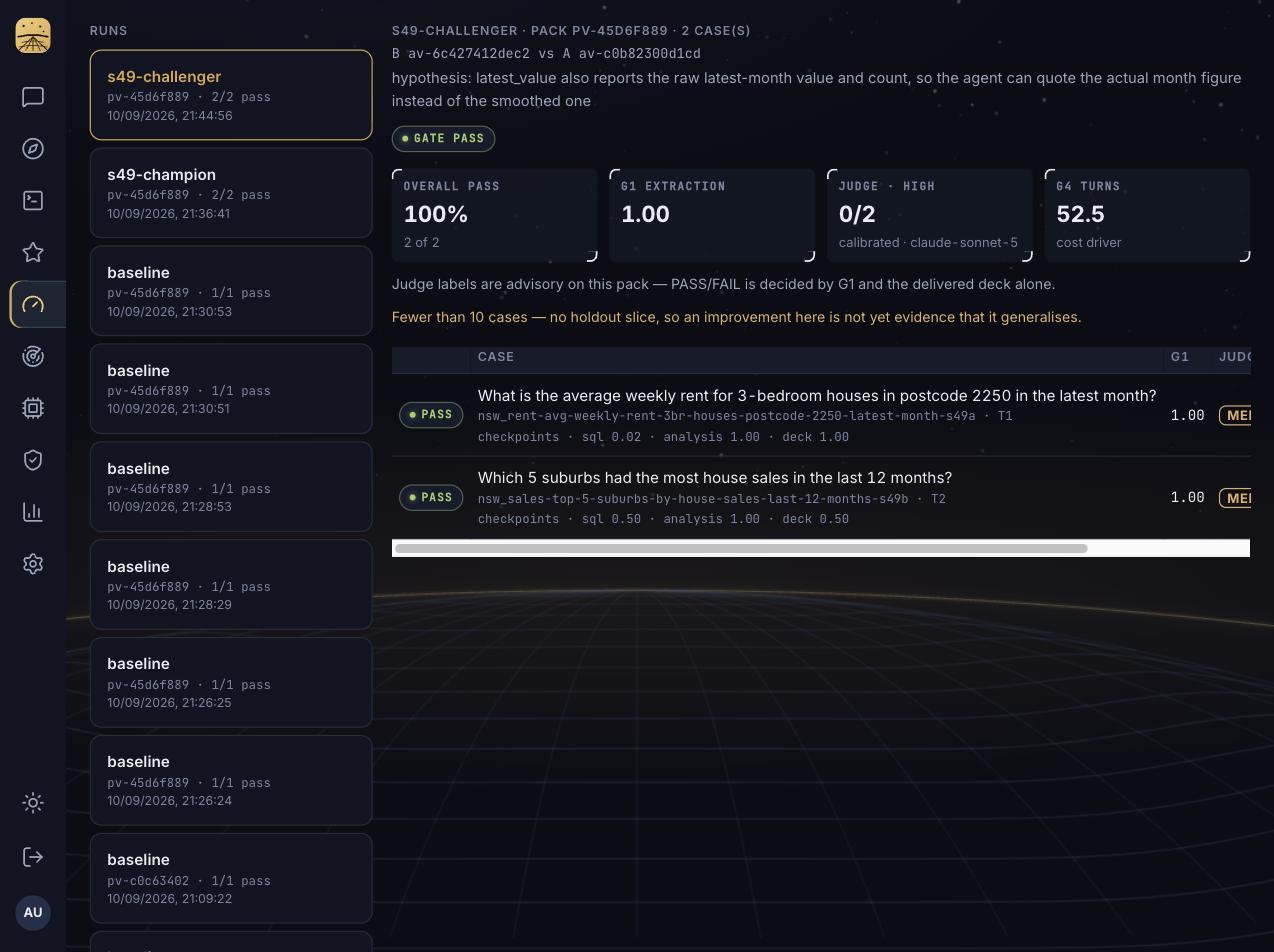
Data QA Agent exige un test statistique avant de promouvoir un challenger.
Le registre compare désormais les cas gagnés et perdus par paire avec un test exact unilatéral ; égalités et petits jeux restent en HOLD malgré un meilleur taux brut.
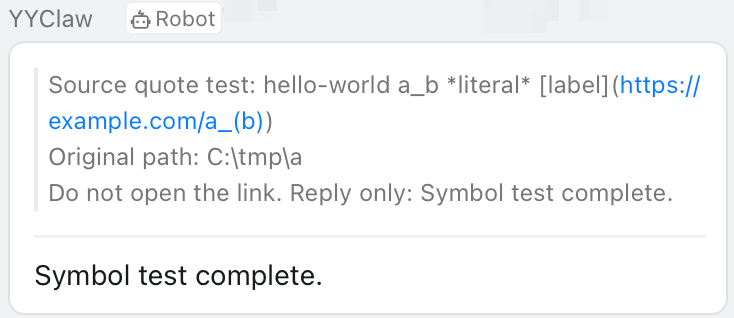
Multica ajoute citations contextuelles et réactions de cycle de tâche dans DingTalk.
Les agents citent le message source dans les groupes, suivent le traitement par réactions et n’ajoutent « Done » qu’après livraison complète de la réponse.
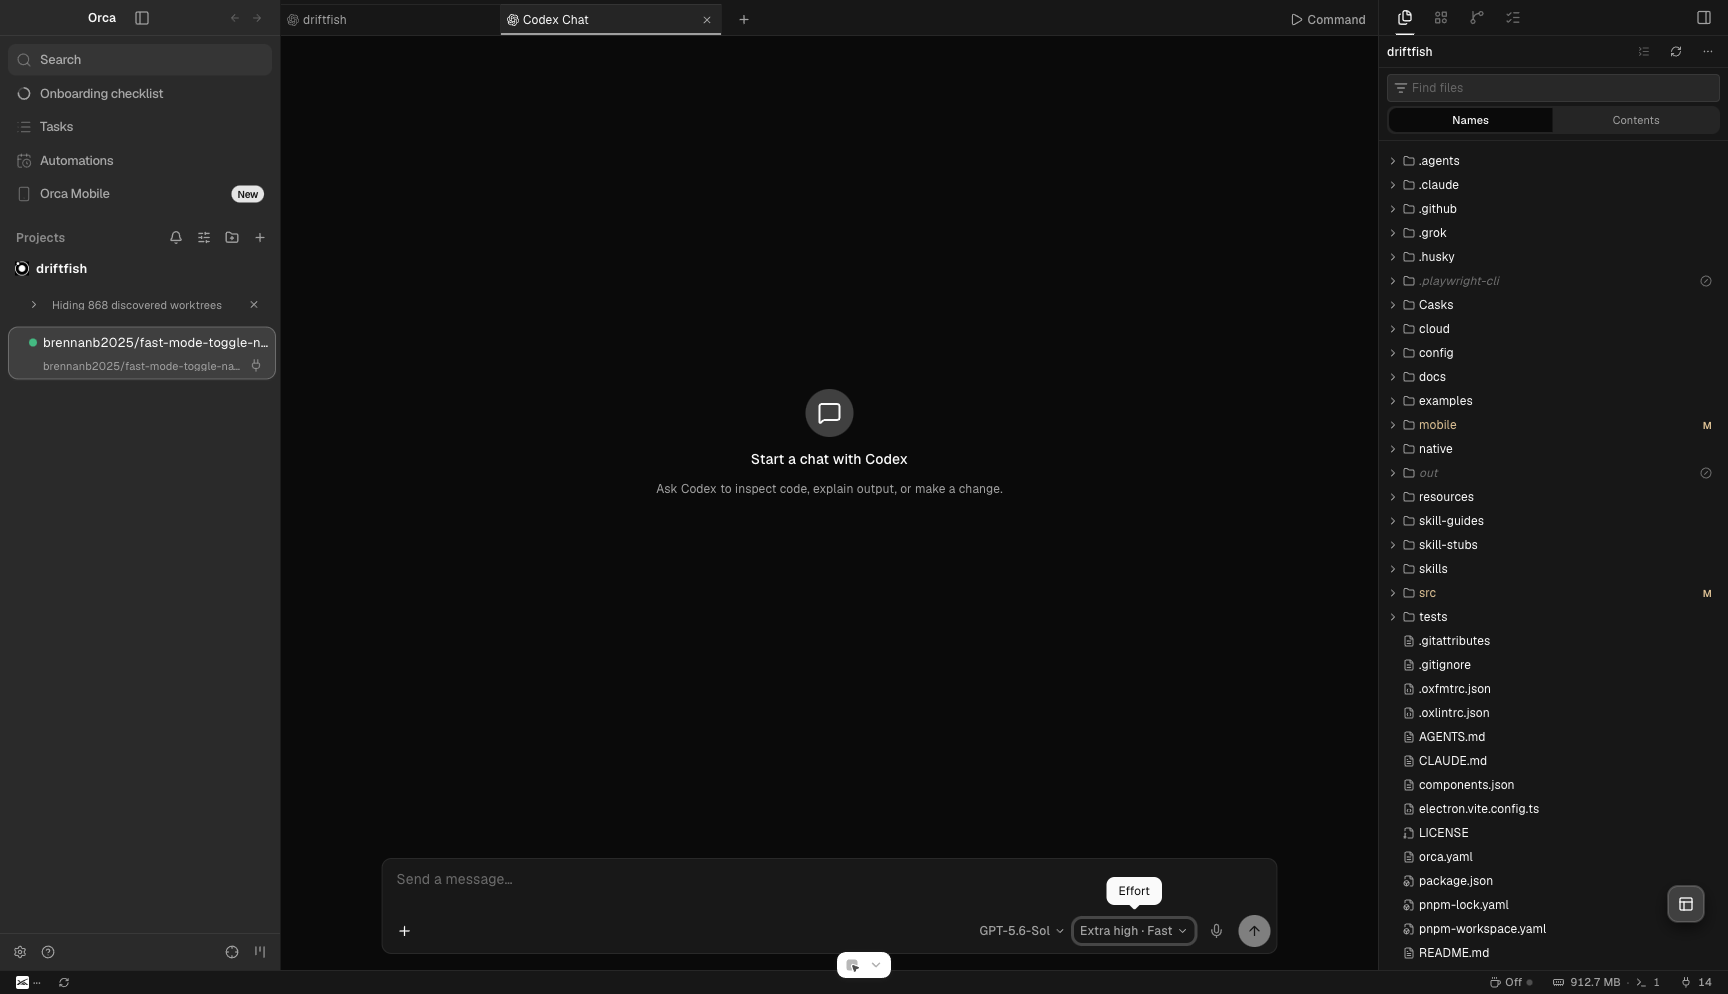
Orca n’affiche le mode Fast que quand Codex ou Claude le supportent.
Le choix Fast dépend désormais des capacités du provider et du modèle, reste mémorisé après restauration et repasse sur Standard lorsque Codex ne publie pas encore cette capacité.
Anthropic traite désormais un plugin ou un skill comme une pièce testable du runtime. `claude plugin eval` rejoue des prompts réalistes avec puis sans le plugin, répète les cas, note outils et artefacts produits, puis peut bloquer la CI. Le gain doit être mesuré, pas seulement déduit du fait que l’instruction se charge.
Next.js applique déjà cette logique aux règles de projet. Ses Agent Evals exécutent les mêmes tâches avec et sans la documentation `AGENTS.md` : plusieurs agents passent de 81–90 % à 90–97 % de réussite. Les instructions deviennent ainsi un facteur de performance mesuré, aux côtés du modèle, de la durée et du coût.
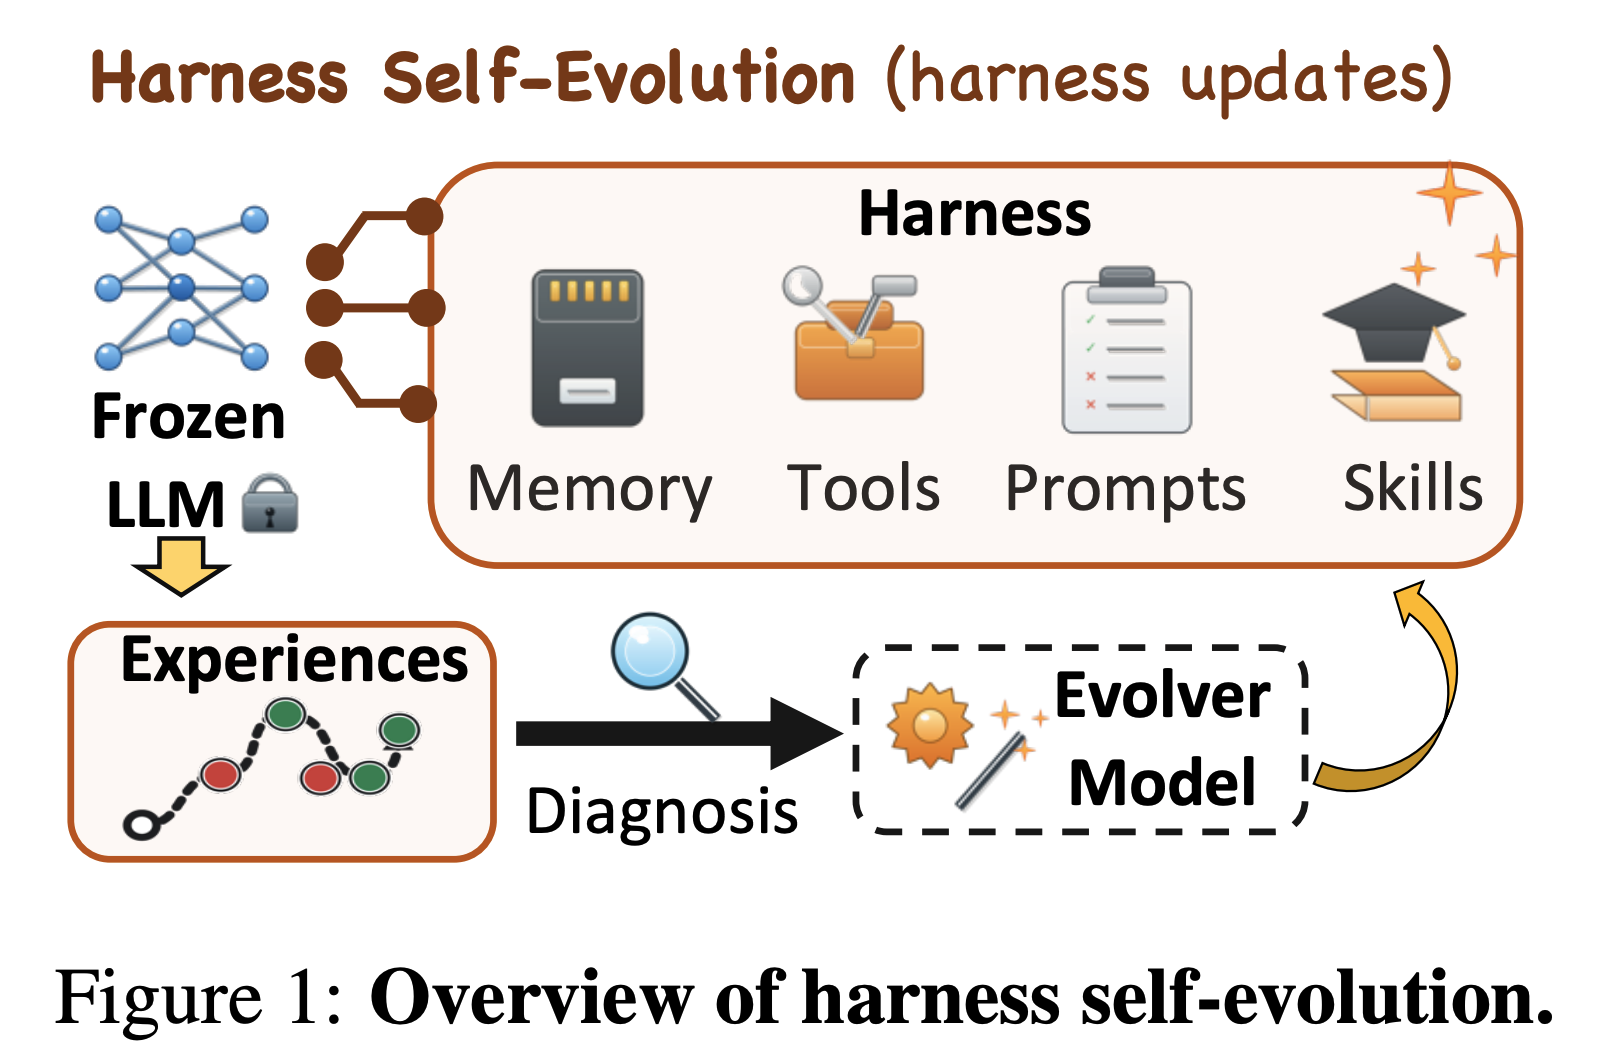
HarnessDev pousse l’idée jusqu’au code du harness. Dans l’analyse publiée par MarkTechPost, seules 34 des 64 évolutions comparables améliorent les scores visibles et cachés dans la même direction. Pour les développeurs, prompts, skills, règles et orchestration deviennent donc des artefacts versionnés à soumettre à des jeux de tests, des seuils et un rollback.
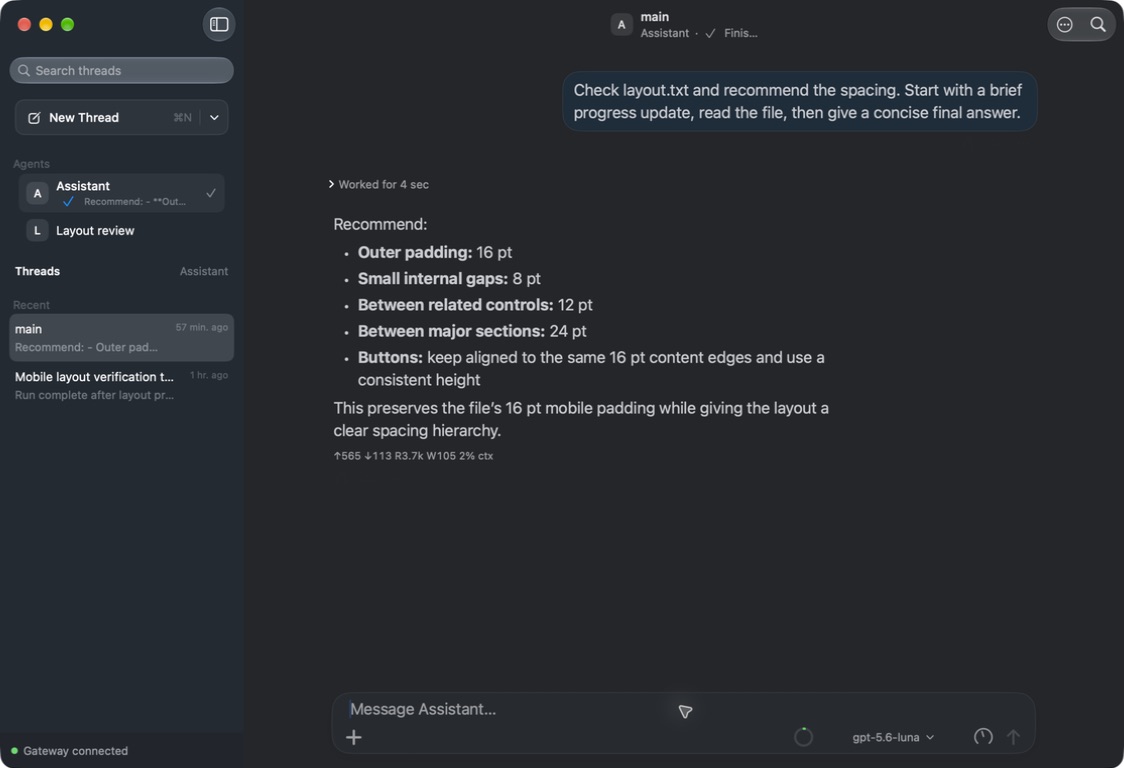
OpenClaw replie le travail terminé au-dessus des réponses sur macOS.
La fenêtre de chat regroupe désormais commentaires et appels d’outils terminés dans « Worked for… », tout en gardant la réponse visible et les travaux actifs ou en échec dépliés.
Smarty Code ordonne les écritures de réglages dans un même runtime.
Les lots concurrents attendent désormais les écritures plus anciennes avant de relire la révision du projet, évitant conflits 412 et options perdues entre web, desktop, VS Code et mobile.