Les coding agents testent désormais leurs skills, instructions et harness comme du code
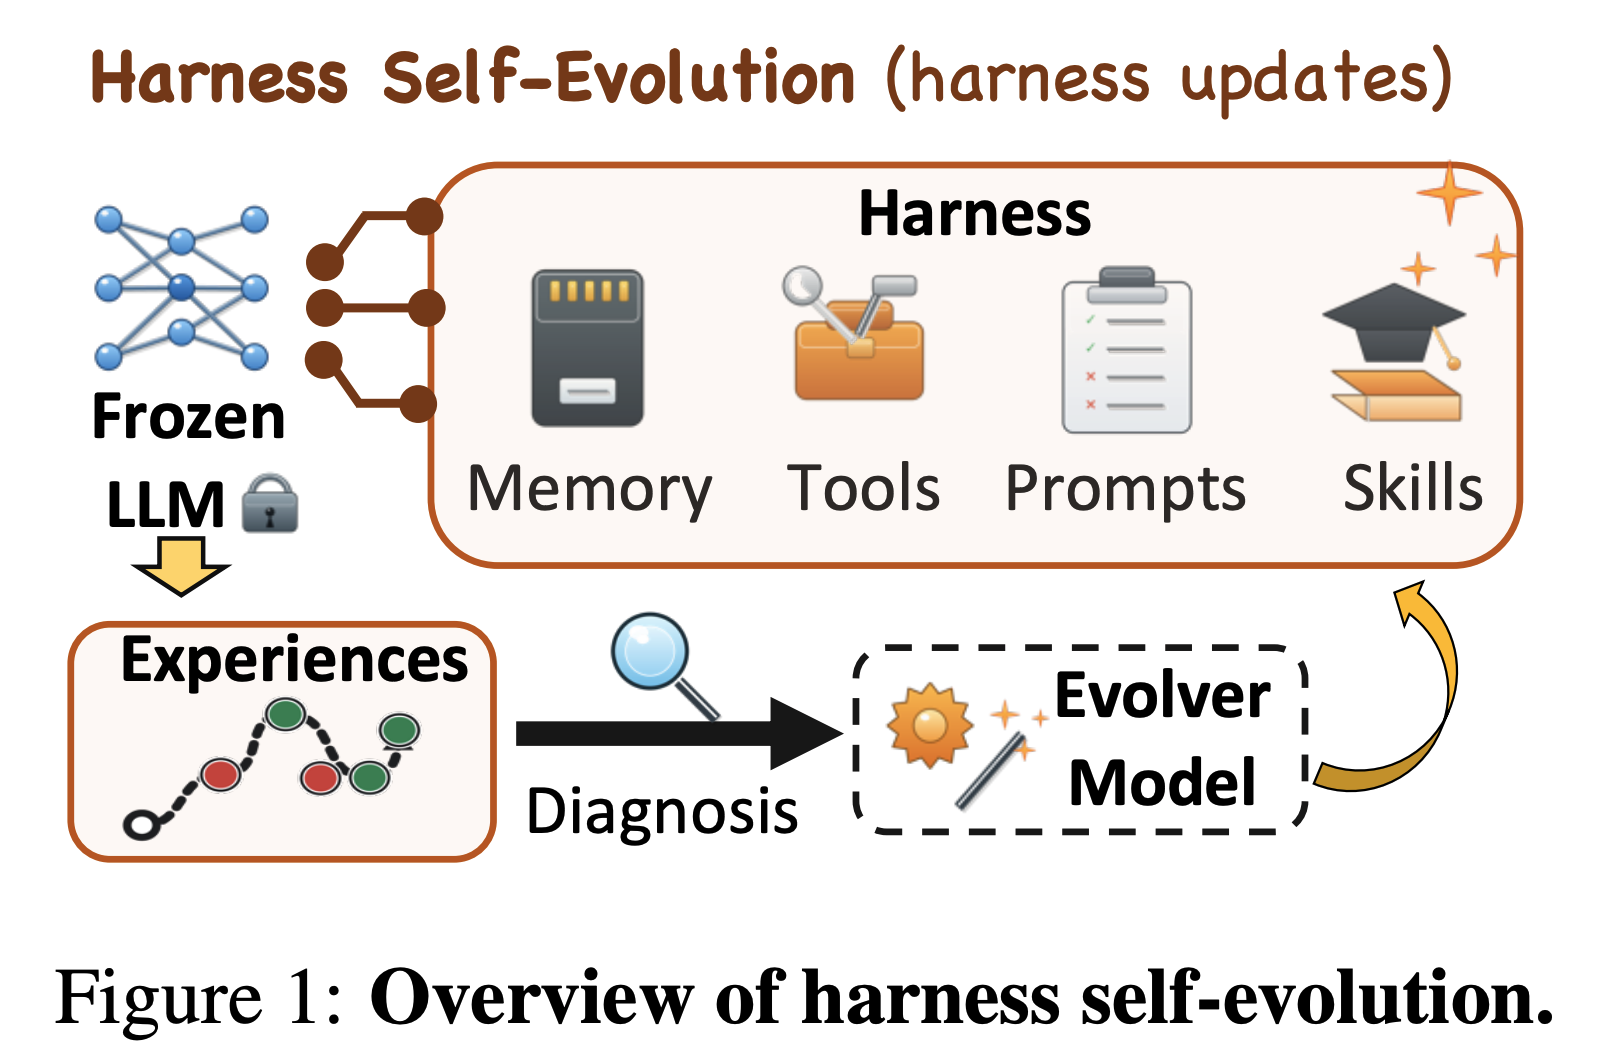
Anthropic traite désormais un plugin ou un skill comme une pièce testable du runtime. `claude plugin eval` rejoue des prompts réalistes avec puis sans le plugin, répète les cas, note outils et artefacts produits, puis peut bloquer la CI. Le gain doit être mesuré, pas seulement déduit du fait que l’instruction se charge.
Next.js applique déjà cette logique aux règles de projet. Ses Agent Evals exécutent les mêmes tâches avec et sans la documentation `AGENTS.md` : plusieurs agents passent de 81–90 % à 90–97 % de réussite. Les instructions deviennent ainsi un facteur de performance mesuré, aux côtés du modèle, de la durée et du coût.
HarnessDev pousse l’idée jusqu’au code du harness. Dans l’analyse publiée par MarkTechPost, seules 34 des 64 évolutions comparables améliorent les scores visibles et cachés dans la même direction. Pour les développeurs, prompts, skills, règles et orchestration deviennent donc des artefacts versionnés à soumettre à des jeux de tests, des seuils et un rollback.
Sources
Chaque onglet présente la publication d’origine et son lien direct.
Test plugins with evals
La documentation décrit `claude plugin eval` : des prompts réalistes sont exécutés plusieurs fois avec et sans plugin, notés par six types de graders, puis comparés par delta. Les suites peuvent fixer un seuil, un budget de coût et servir de gate dans la CI pour détecter les régressions d’un plugin ou d’un skill.
Next.js Agent Evals
La page compare des coding agents sur de vraies tâches Next.js avec durée, coût et taux de réussite, puis rejoue les évaluations avec la documentation `AGENTS.md`. Au run du 11 septembre 2026, plusieurs agents gagnent nettement avec cette couche documentaire, tandis que les meilleurs restent parfois inchangés.
Can LLMs Engineer Their Own Agent Harness? ByteDance Seed’s HarnessDev Says Only 34 of 64 Changes Generalize
L’article présente HarnessDev, qui évalue le harness exécutable plutôt que la seule réponse finale. Sur 64 changements de versions comparables, 34 font évoluer feedback visible et score held-out dans le même sens ; les résultats montrent aussi une forte dépendance au modèle qui exécute le harness.
Disentangling Agent Self-Evolution
Cette lecture de recherche distingue l’évolution du harness de celle du modèle et illustre la boucle où mémoire, tools, prompts et skills sont modifiés à partir d’expériences et de diagnostics. Son schéma éditorial sert d’illustration à l’Article.