La boucle vocale temps réel se sépare du raisonnement et des actions métier
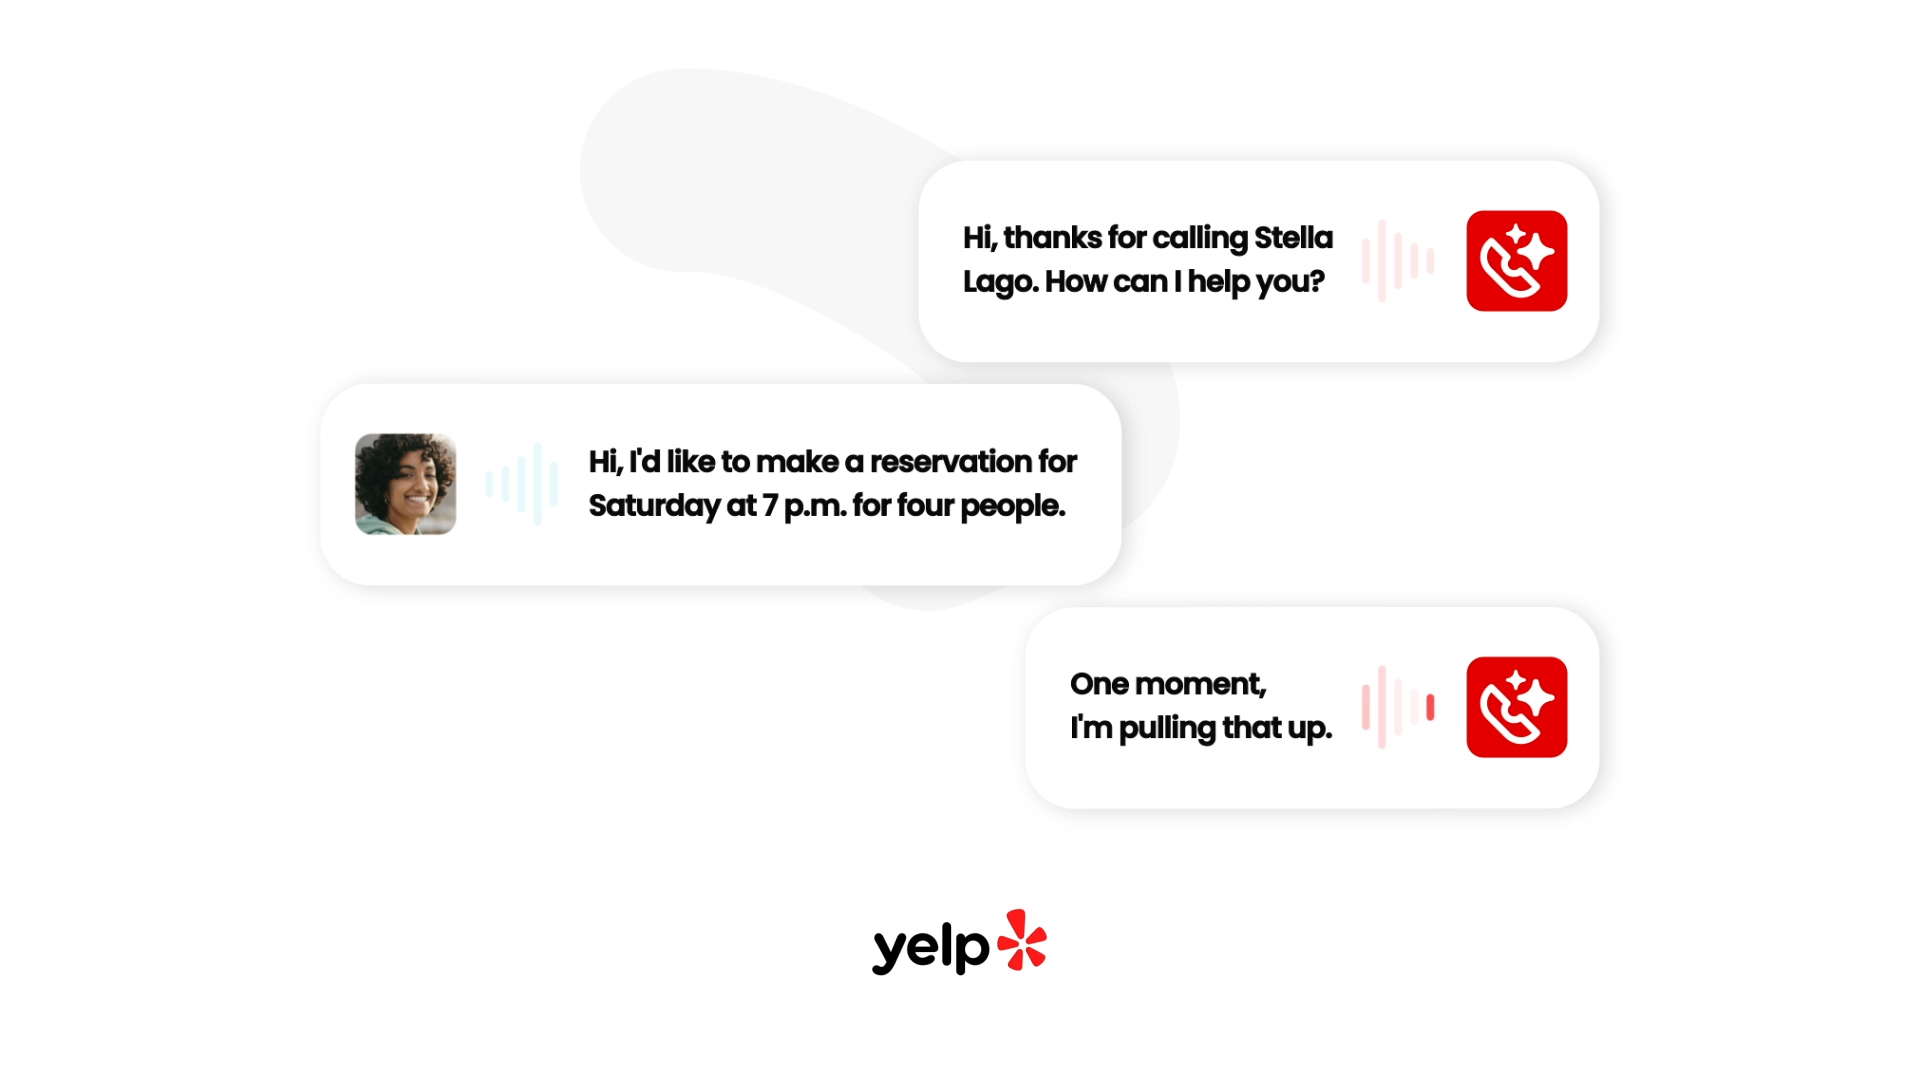
La boucle vocale devient un runtime distinct du travail de fond. Avec GPT‑Live‑1, écoute et parole fonctionnent en full-duplex, interruptions et silences restent dans la couche audio, puis raisonnement et tool calling sont délégués à un modèle backend. Les développeurs n’ont plus à orchestrer une chaîne STT‑LLM‑TTS pour chaque échange.
Yelp montre ce découpage en production : GPT‑Live‑1 sert de couche vocale frontale à Yelp Host et Hatch, tandis que les données métier gèrent disponibilités, règles de réservation et routage. L’entreprise observe davantage d’appels traités sans transfert et des phrases plus naturelles, signe que la voix peut évoluer sans réécrire l’intelligence opérationnelle.
Deepgram expose en parallèle des contrôles de session pour écouter, réfléchir, parler, interrompre ou modifier le prompt à chaud. Surtout, `defer_until_eot` retarde une action irréversible jusqu’à confirmation du tour utilisateur et annule l’appel si la personne reprend la parole. Le contrat de l’agent vocal devient donc : conversation spéculative, effets de bord confirmés.
Sources
Chaque onglet présente la publication d’origine et son lien direct.
Build more natural voice experiences with GPT‑Live‑1 in the API
OpenAI lance GPT‑Live‑1 dans l’API : le modèle écoute et parle simultanément, gère interruptions et silence, et peut déléguer raisonnement et tool calling à un modèle backend ou tiers tandis que la conversation continue.
Yelp and Hatch Advance Voice AI for Restaurants and Service Pros with OpenAI's GPT-Live-1
Yelp annonce l’intégration de GPT‑Live‑1 dans Yelp Host et Hatch comme couche vocale frontale reliée aux données et règles métier. Les premiers tests en production montrent une meilleure prise en charge des appels, moins de transferts et des phrases plus naturelles.
@deepgram/react 0.2.0
Deepgram ajoute à son SDK React des contrôles de runtime pour injecter, mettre en file ou interrompre un message, modifier écoute, réflexion, parole et prompt pendant une session, et fiabiliser le nettoyage des ressources lors des arrêts et reconnexions.
Hold a function call until the user’s turn is confirmed
Deepgram introduit `defer_until_eot` pour retarder une fonction à effet irréversible jusqu’à confirmation de fin de tour. Si l’utilisateur reprend la parole, l’appel est abandonné et le client peut recevoir un signal explicite `FunctionCallCancelled`.
Yelp and Hatch Advance Voice AI for Restaurants and Service Pros with OpenAI's GPT-Live-1
La diffusion Business Wire de l’annonce Yelp fournit l’illustration éditoriale montrant un appel Yelp Host avec GPT‑Live‑1, ainsi que les détails de l’intégration de la couche vocale aux systèmes métier de Yelp et Hatch.