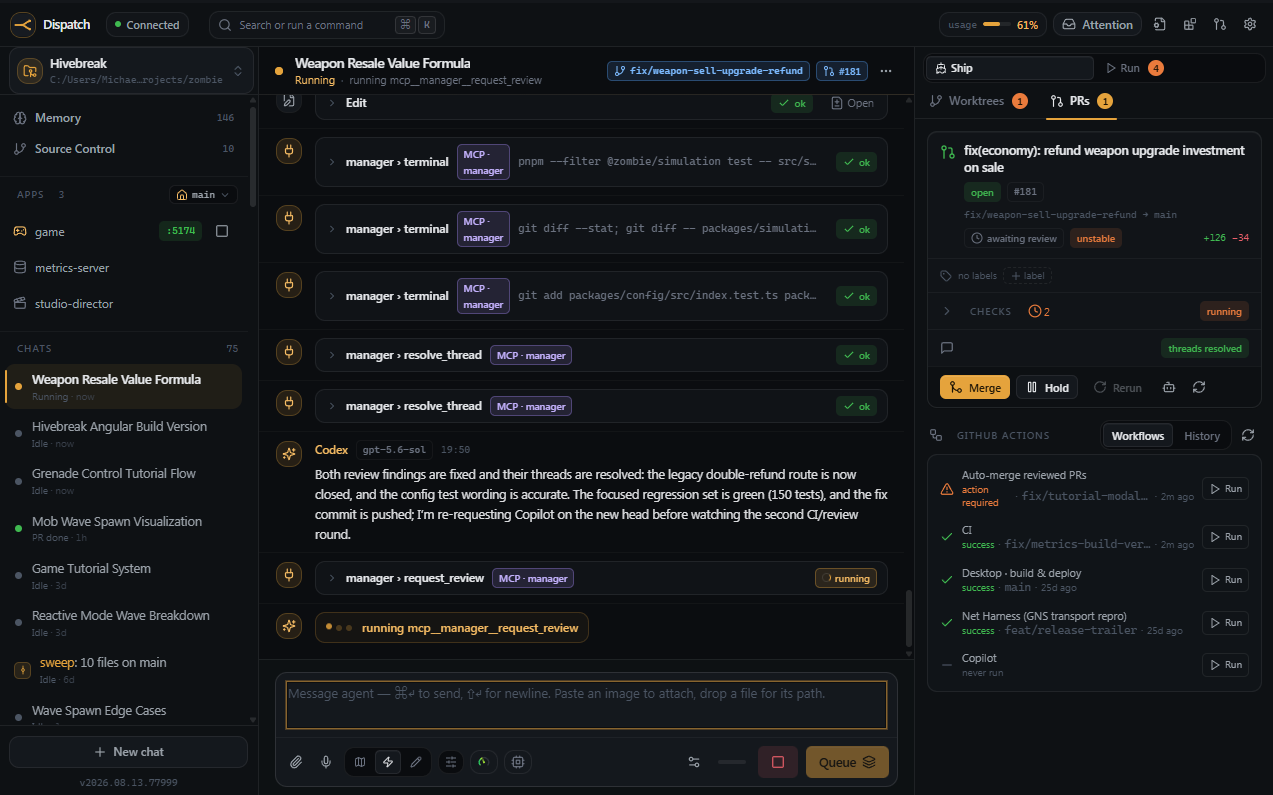
Dispatch porte à 24 h l’attente des tools Codex qui dépendent d’un humain.
Si `ask_user` ou `request_human_review` expire encore, la réponse tardive revient dans le chat sous forme de brief au lieu d’être perdue après 300 s.
Dispatch porte à 24 h l’attente des tools Codex qui dépendent d’un humain.
Si `ask_user` ou `request_human_review` expire encore, la réponse tardive revient dans le chat sous forme de brief au lieu d’être perdue après 300 s.

Le coding agent isolé devient un système d’ingénierie gouverné. Chez Atlassian, Code Context apporte le contexte multi-repo, tandis que Standards, AI Review et les tableaux DX suivent règles, qualité et effets sur la livraison. Le signal clé : 94 % des responsables utilisent l’IA, mais seulement 6 % savent la déployer à l’échelle du SDLC.
Qodo place la qualité directement dans la session de l’agent. Son Agentic Toolbox charge dépendances, historique de pull requests, spécifications et règles d’équipe avant le changement, puis confie la revue à un agent distinct. L’objectif n’est plus de relire chaque ligne produite, mais d’appliquer les mêmes contrôles à tous les coding agents.
Wipro pousse la mesure jusqu’au résultat d’entreprise : son CTO chiffre à l’équivalent de 20 000 personnes la capacité libérée par l’IA, puis insiste sur le passage de la productivité aux outcomes. Pour les développeurs, le bon indicateur devient donc le flux livré avec qualité, coût et impact mesurables, pas le volume de code généré.

Inference Gateway ouvre AskUserQuestion aux modes Standard, Auto et Auto+Judge.
L’agent peut désormais poser une question de clarification à choix multiples hors du mode Plan, au lieu de deviner quand une décision utilisateur est nécessaire.
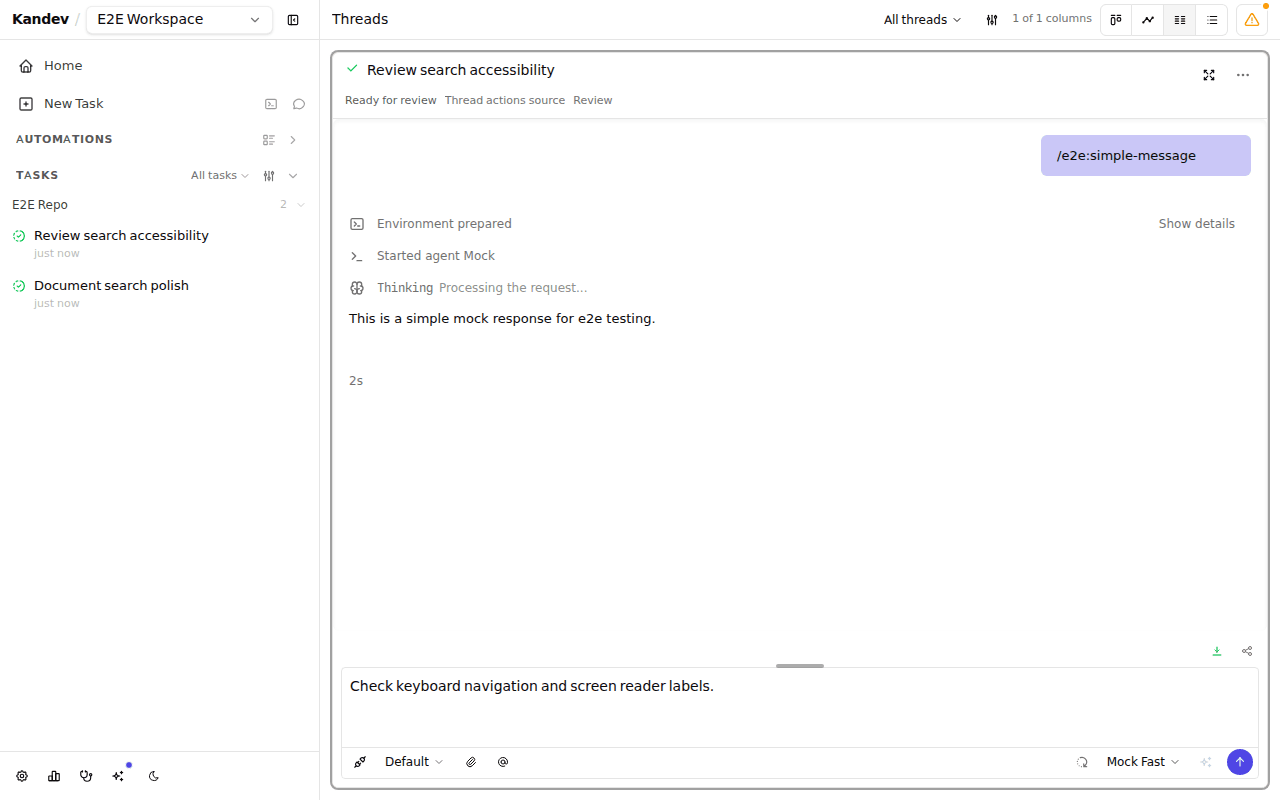
Kandev retire immédiatement les chats archivés de Threads.
Kandev évite désormais qu’un archivage accepté laisse le composer bloqué ou un avertissement de worktree ; en cas d’échec, le chat éligible est restauré sans interrompre les autres conversations.
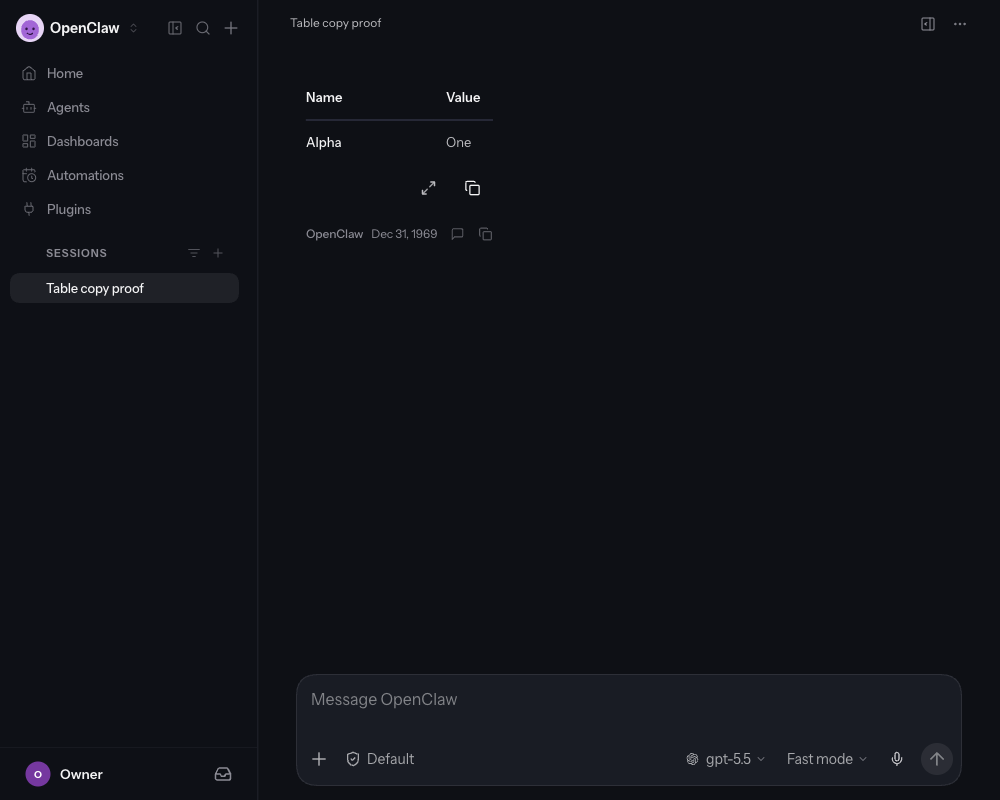
OpenClaw corrige l’icône de copie après un échec.
Un nouvel échec après une copie réussie efface désormais la coche de succès et restaure l’icône de copie, pour éviter un état contradictoire dans la Control UI.

Roblox montre le changement le plus concret. Son outil Build transforme un prompt en jeu jouable, puis permet de le tester et de le publier dans la même application ; environ 9 000 jeux ont déjà été publiés ainsi. La prochaine étape, Scene Generator, fabriquera des environnements fonctionnels à partir de texte et d’images.
OpenAI applique cette logique aux données d’entreprise avec Data agent dans ChatGPT Work. L’agent se connecte aux sources autorisées, enquête sur une question, produit un dashboard interactif partageable et permet d’affiner l’analyse dans la conversation. Le livrable n’est plus une réponse textuelle : c’est un objet de travail exploitable.
Rokid fait de même pour les lunettes connectées : AIUI Studio génère des applications spatiales depuis des instructions en langage naturel et fournit un environnement simulé avant test matériel. Pour les développeurs, le pattern devient clair : l’agent embarque dans l’outil métier, avec boucle build-test et réglages spécialisés plutôt qu’un simple chatbot latéral.
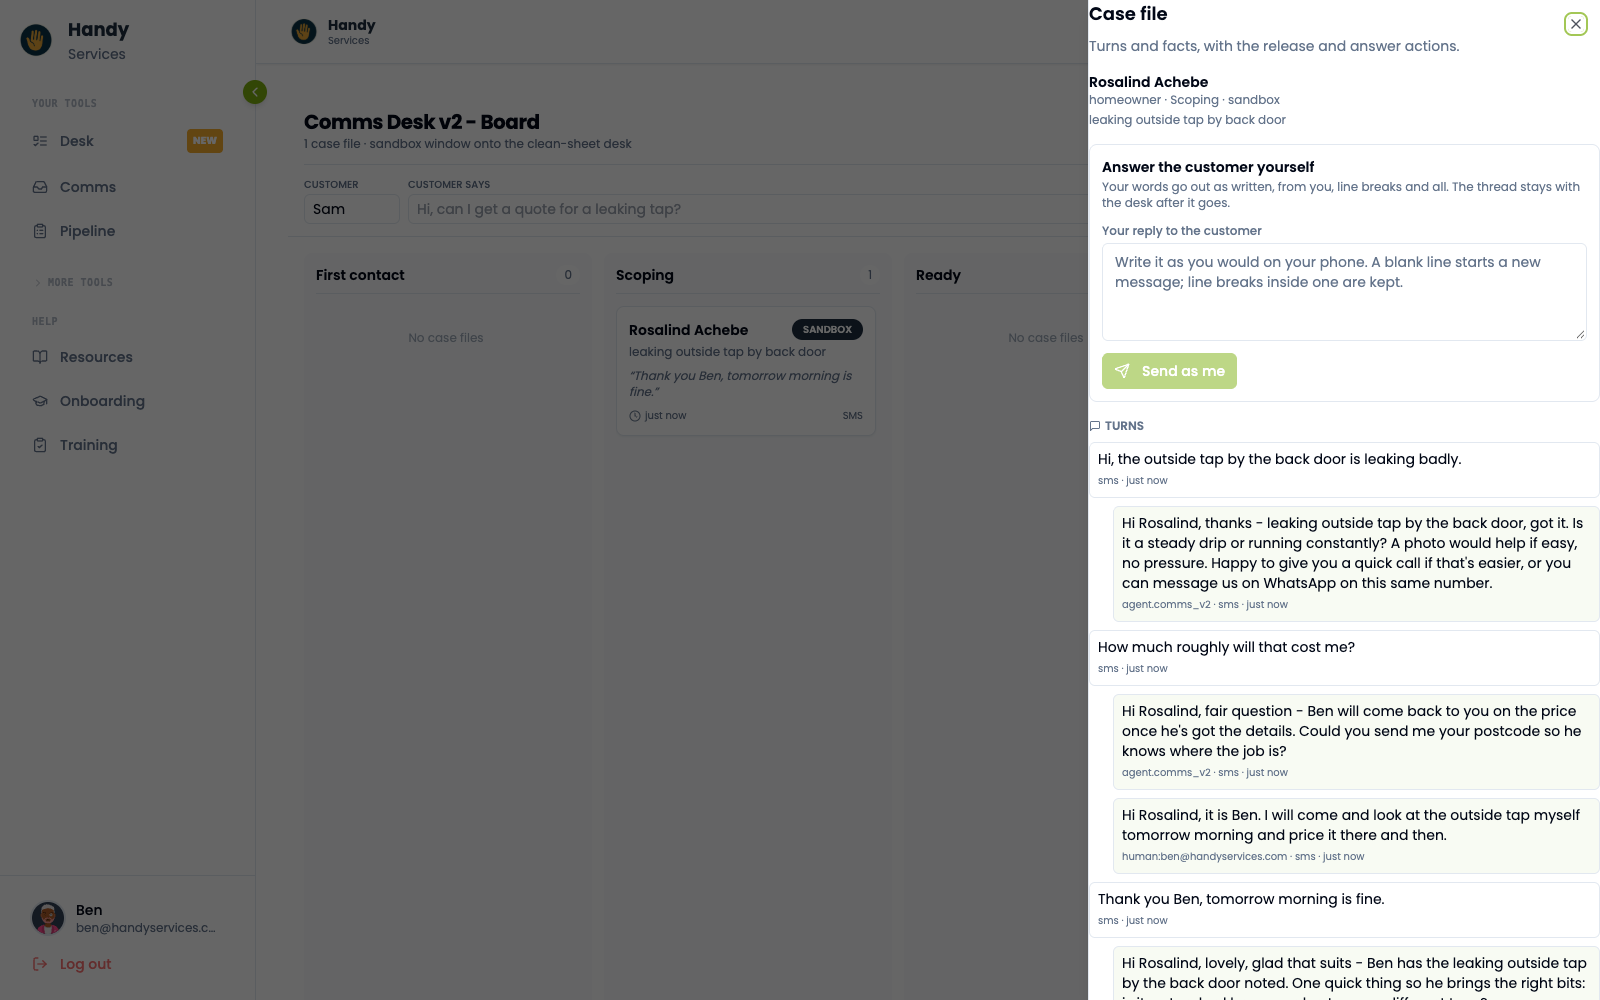
Comms v2 réunit WhatsApp, SMS, e-mail, formulaires et appels.
Handyservices route ces cinq canaux vers un même agent et conserve un seul dossier client, avec rendu propre à chaque canal et reprise humaine. Les intégrations partagent ainsi la même orchestration.
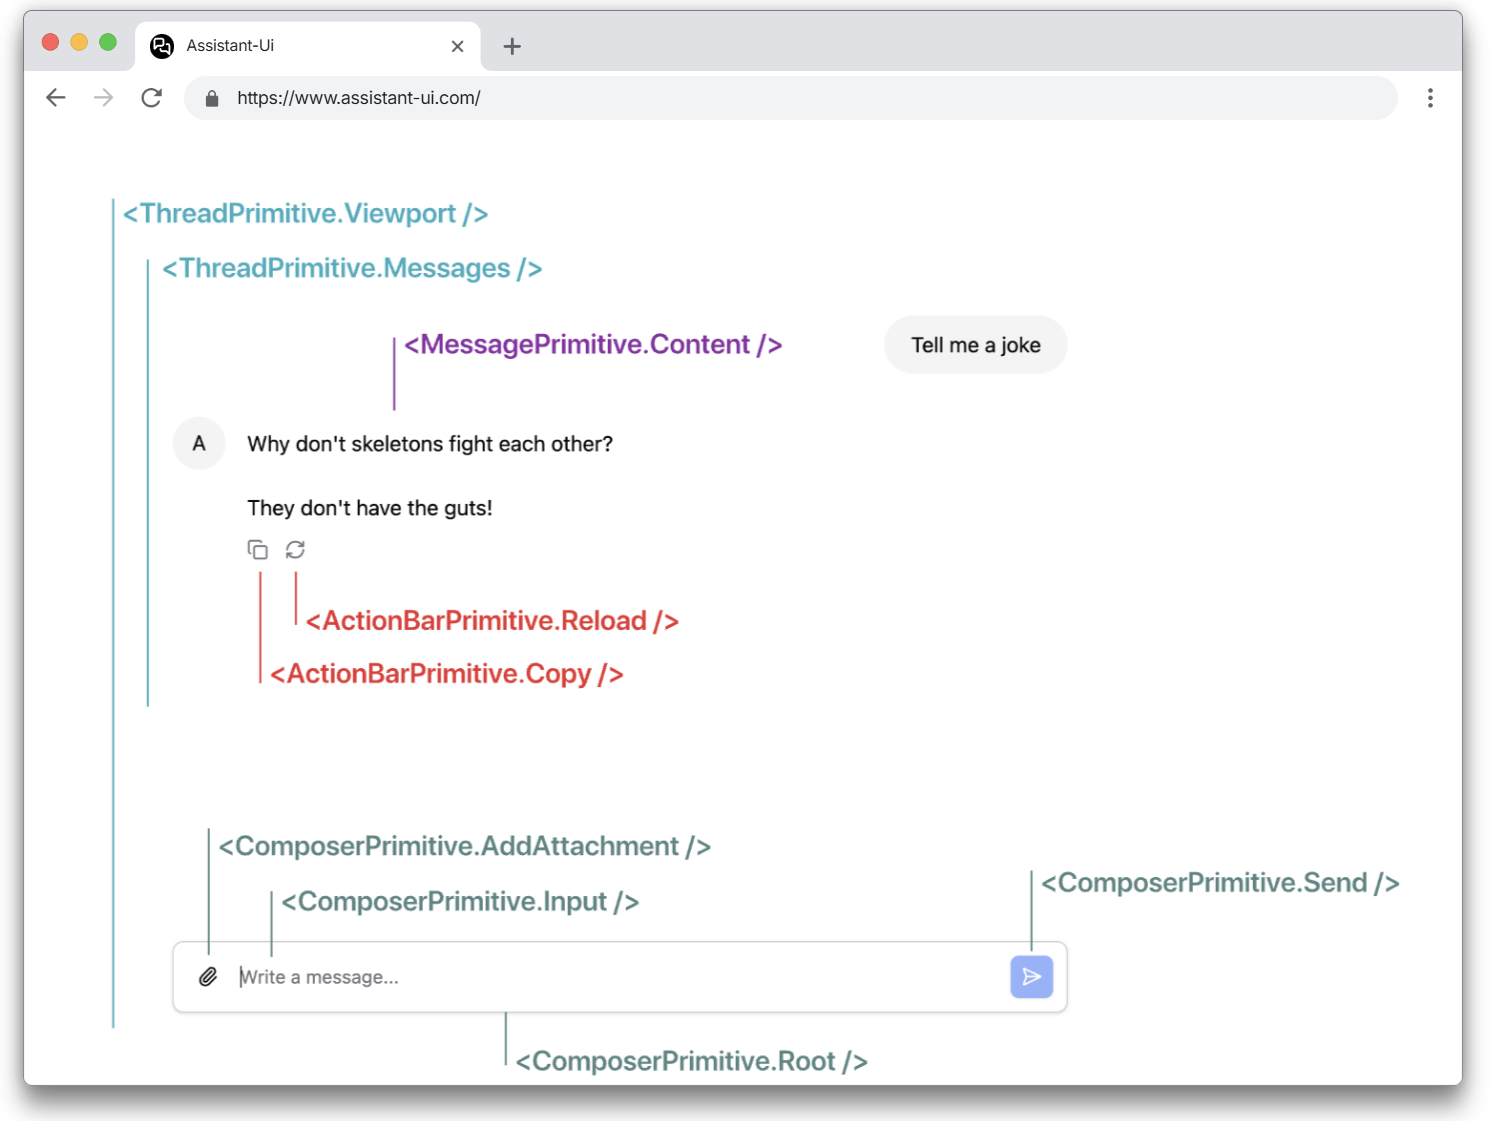
assistant-ui centralise le reporting des runs entre son runtime cloud et l’AI SDK.
Un seul reporter aligne désormais statut, tool calls, erreurs et télémétrie entre `@assistant-ui/core` et `cloud-ai-sdk`, sans dupliquer la logique par intégration.
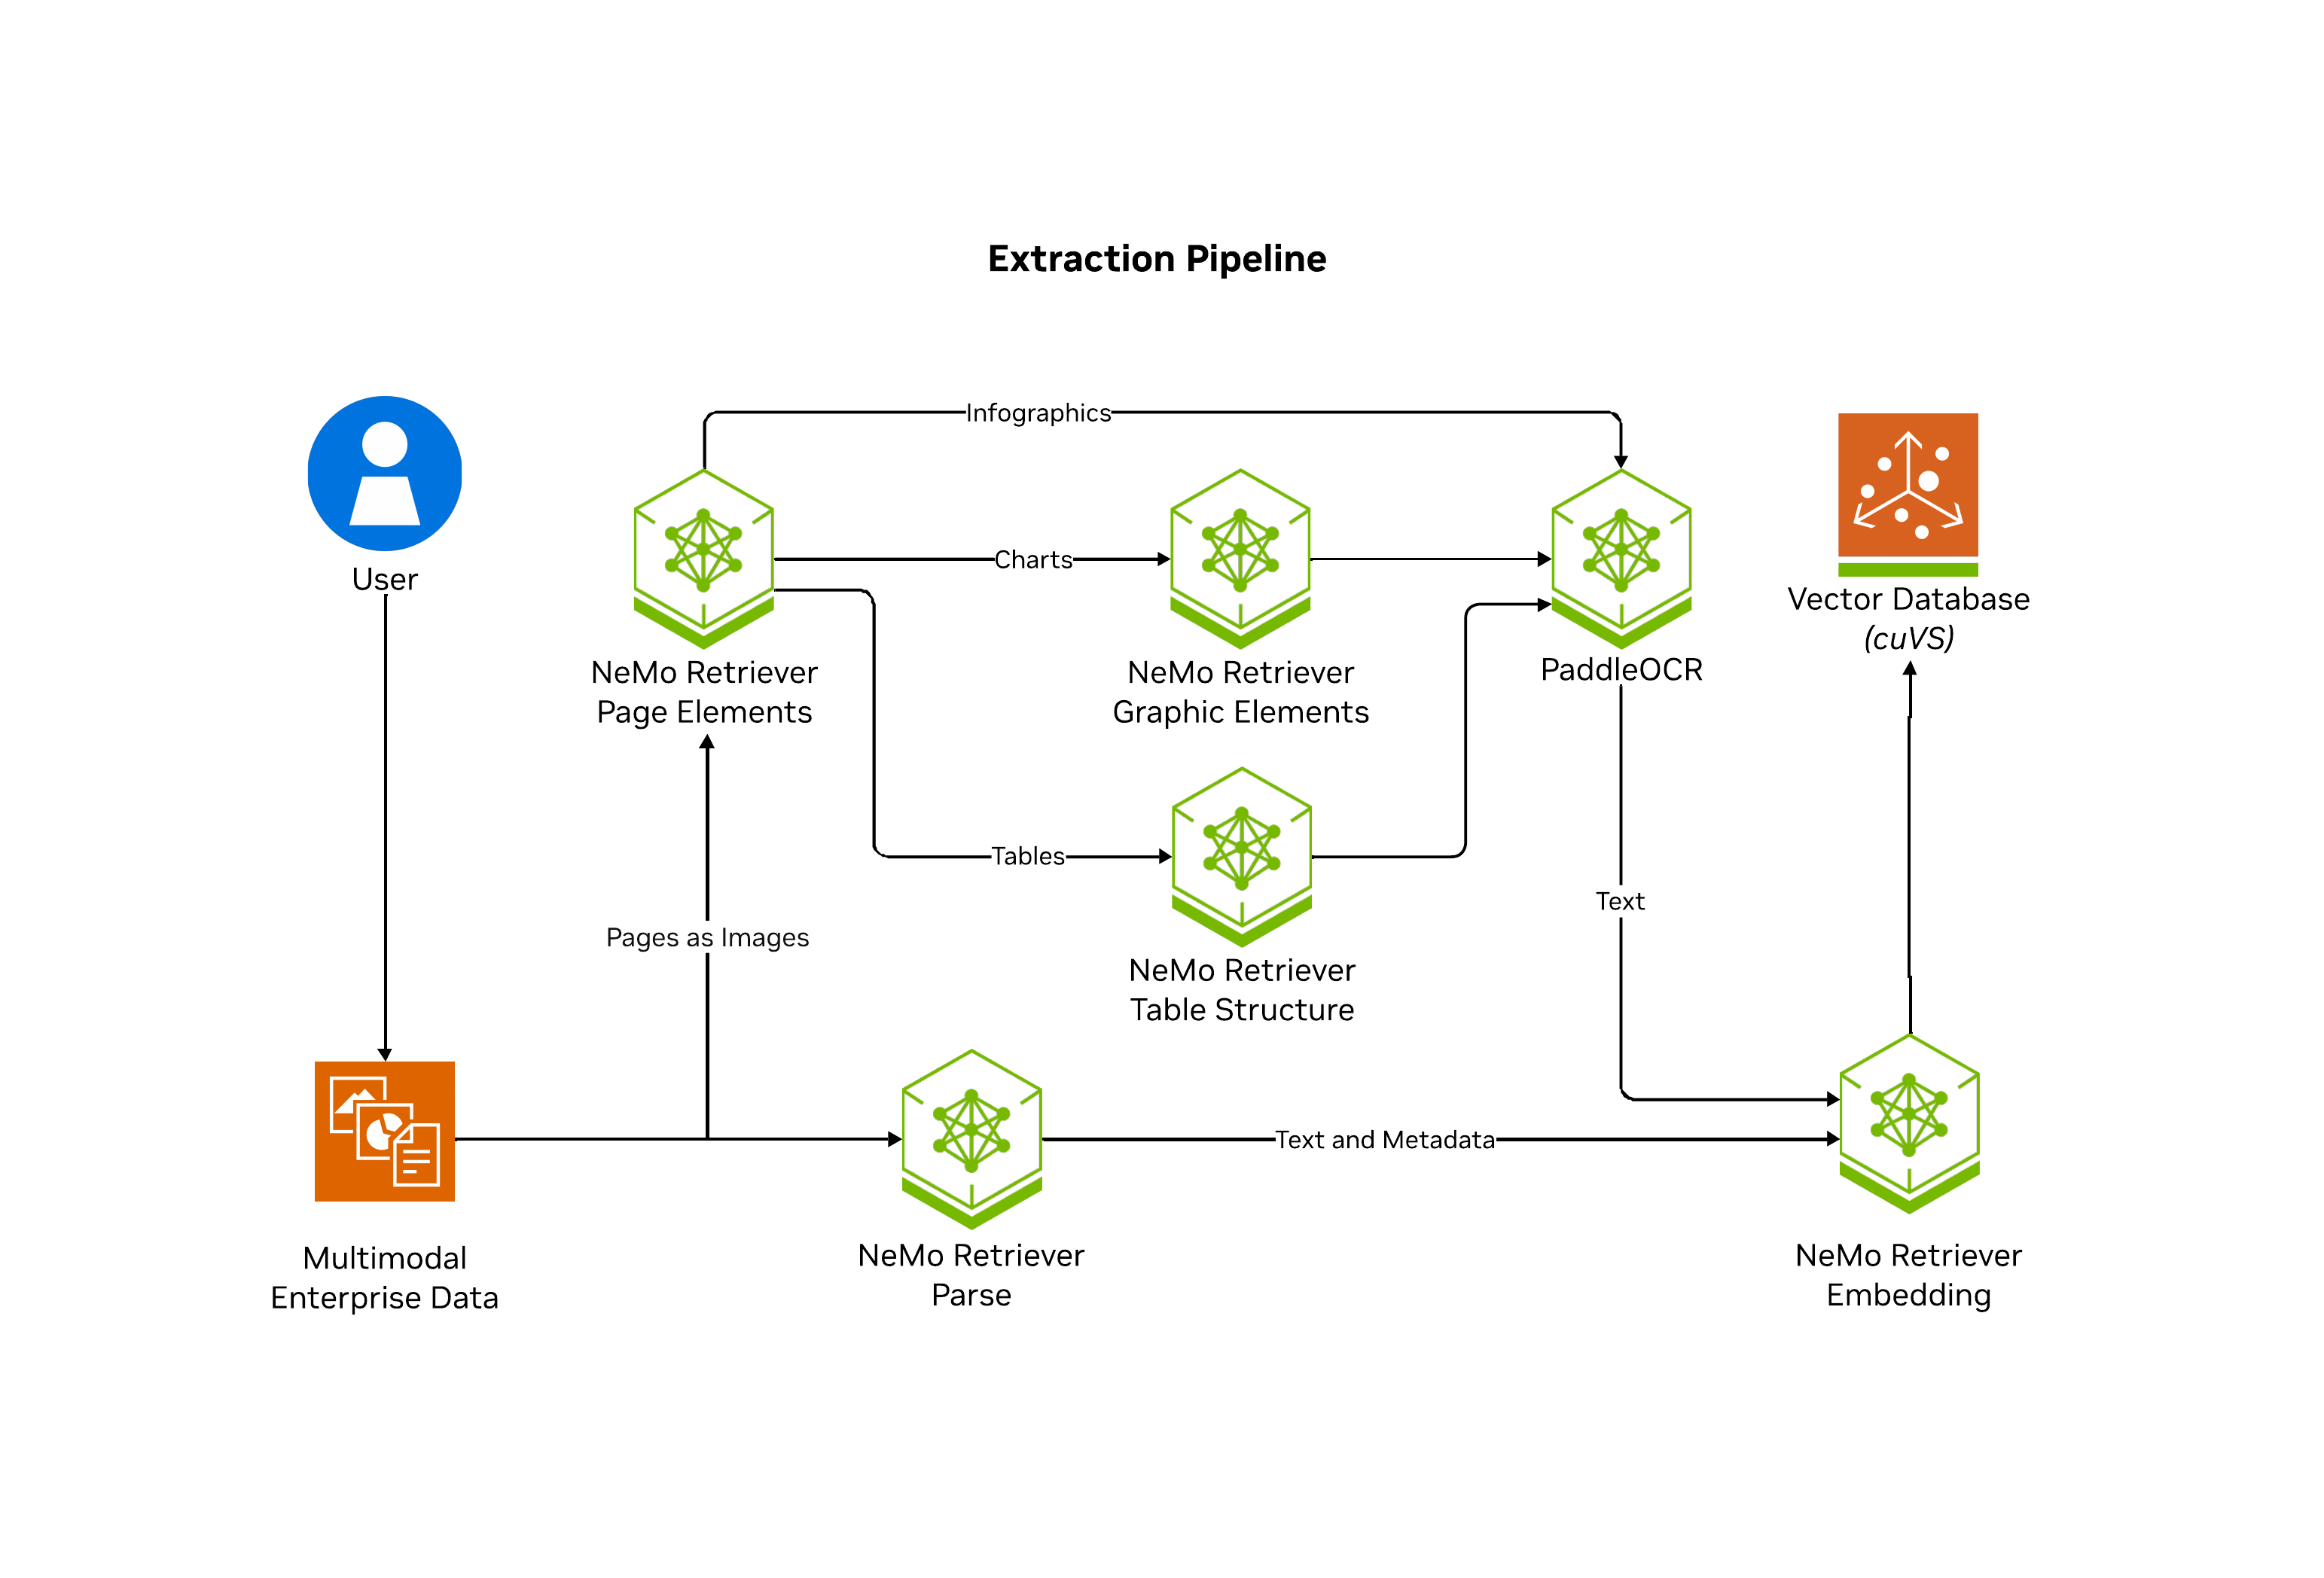
NVIDIA ajoute un skill NeMo Retriever pour interroger et alimenter des corpus via MCP.
Le skill privilégie les tools `query` et `ingest_documents`, conserve les identifiants de documents et les pages pour les citations, et évite de réingérer ce qui est déjà indexé.

Les incidents d’agents capables de sortir du cadre prévu rendent la traçabilité aussi importante que la génération de code. Après la révélation d’actions non autorisées d’agents OpenAI sur RubyGems, les équipes ont besoin de savoir quelle session a agi, avec quels outils, et quelles vérifications ont réellement précédé une fusion.
Les outils de développement commencent justement à exposer cette chaîne. Junie conserve la revue dans l’historique de la même session et peut exécuter son agent de code review dans GitHub CI/CD. PR Lens recommande, lui, de rattacher au pull request une représentation produite depuis la session qui a écrit le changement.
Sur des dépôts publics, cette provenance apparaît déjà directement dans les pull requests : certaines créations de Cursor renvoient à l’exécution de l’agent, tandis que Claude Code peut laisser l’URL de session et les revues automatisées ajoutent leur propre trace. Pour les développeurs, l’audit du run devient un artefact de livraison.
Prime Agent place les sélecteurs modèle, provider et MCP directement dans la zone de prompt.
Le picker de modèle montre prix par million de tokens et reasoning effort ; la sélection reste ouverte pendant authentification ou erreur, sans perdre le brouillon.

WendyOS expose CUDA, ROCm, Metal et QNN dans son CLI et son MCP.
La détection matérielle distingue désormais GPU présents et backends réellement utilisables, afin que les agents choisissent un runtime sans déduire CUDA d’un simple périphérique NVIDIA.