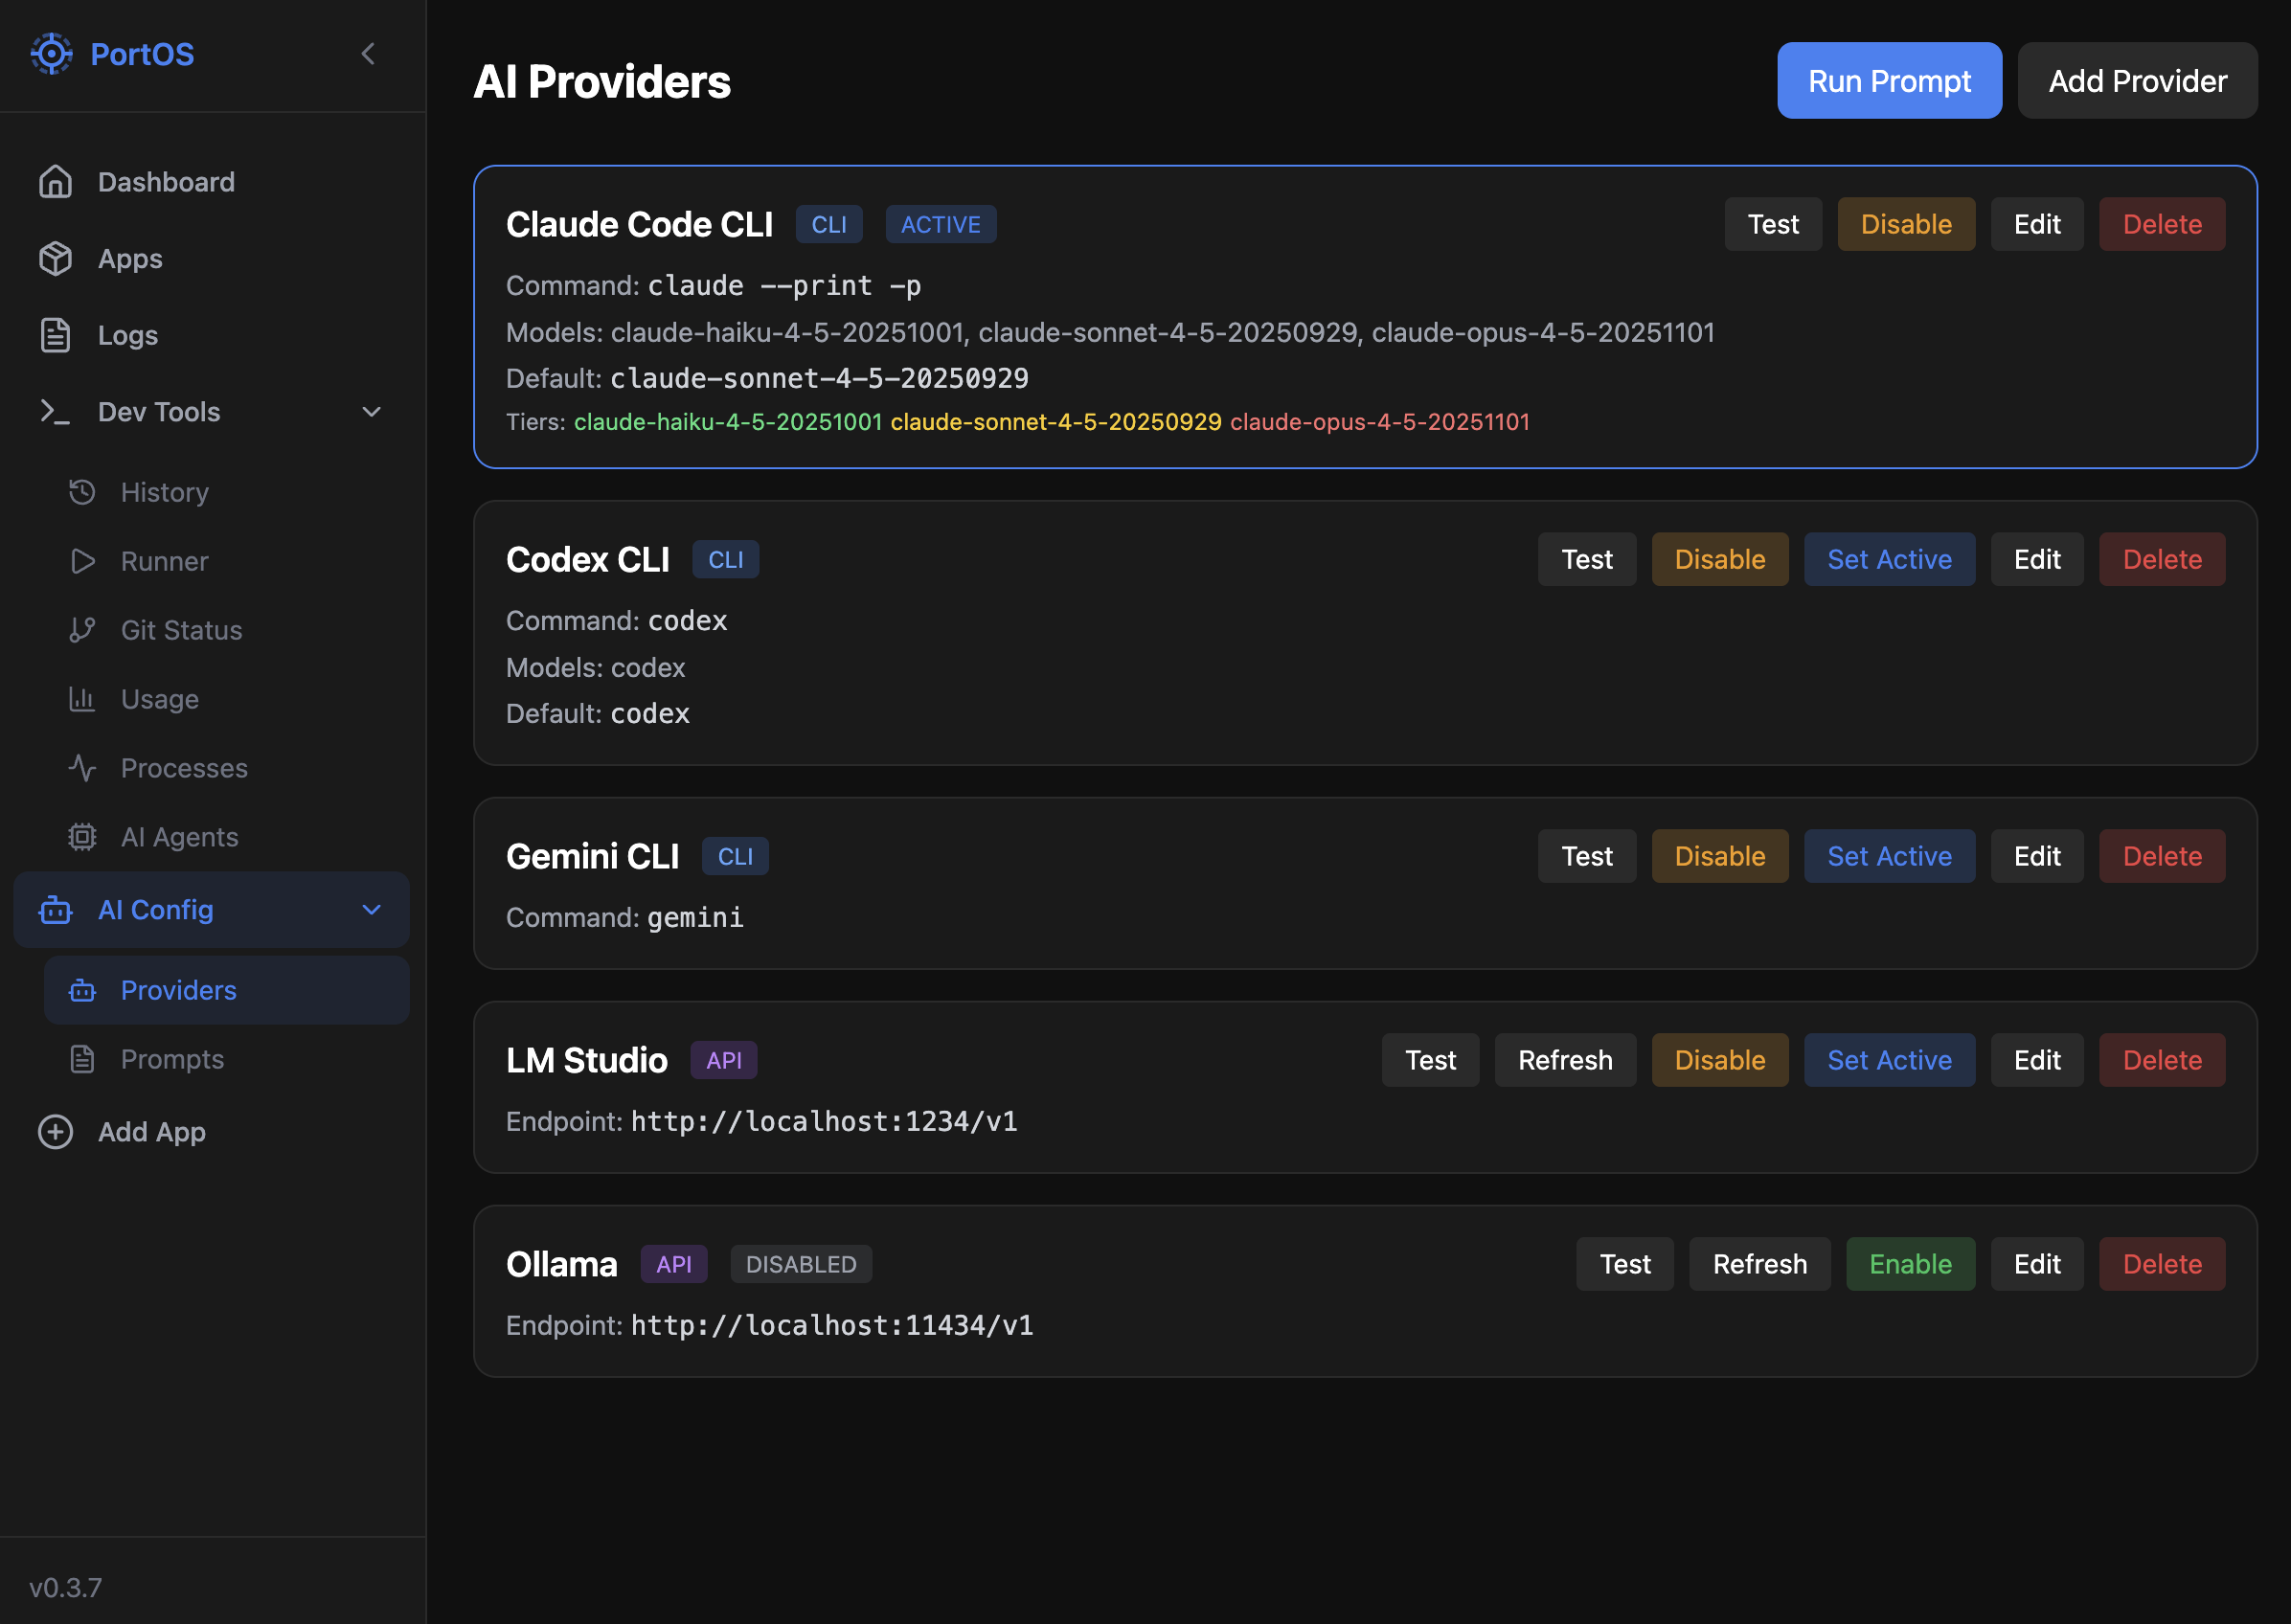
PortOS conserve le niveau d’effort choisi jusqu’aux agents de planification.
Le runtime transporte désormais ensemble provider, modèle et reasoning effort du projet jusqu’aux agents Creative Director ; effacer le pin restaure les défauts.
PortOS conserve le niveau d’effort choisi jusqu’aux agents de planification.
Le runtime transporte désormais ensemble provider, modèle et reasoning effort du projet jusqu’aux agents Creative Director ; effacer le pin restaure les défauts.

Un modèle juge s’insère désormais directement dans le workflow d’un agent. UiPath propose depuis le 7 septembre son garde-fou « LLM as Judge », qui évalue prompts, réponses ou appels LLM selon des instructions métier en langage naturel. Chaque contrôle devient un appel LLM distinct, mesuré et facturé séparément.
PatchBench montre pourquoi ce jugement doit être doublé de vérifications déterministes. Sur onze agents de correction de vulnérabilités, un test limité au PoC gonfle le taux de réussite de 1,83 fois : avec validation de sécurité puis de comportement, les meilleurs agents tombent d’au-dessus de 97 % à environ la moitié des tâches.
Le même déplacement apparaît côté production. MarketScale rapporte que les entreprises poussent désormais contrôles d’accès, journalisation et tests continus jusque dans la couche données, parce que connecteurs, permissions et outils évoluent après déploiement. Pour les développeurs, un score final ne suffit plus : il faut des garde-fous exécutés pendant tout le workflow.
Lightdash aligne les consignes MCP sur les filtres réellement disponibles.
Le serveur MCP et l’agent génèrent désormais leurs instructions de filtrage depuis une source commune, évitant qu’un modèle propose des opérateurs absents du contrat de la requête.
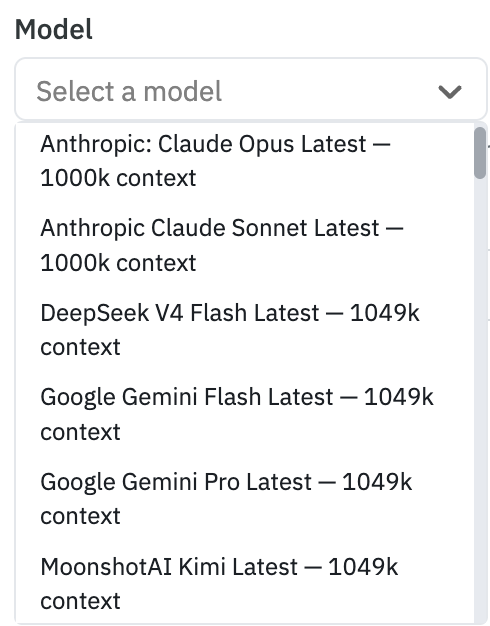
ToolJet détaille coût, durée et effort dans son sélecteur OpenAI.
Six profils affichent crédits et minutes, dont trois niveaux pour GPT‑5.6 Luna ; Sol est recommandé afin de choisir le budget de l’agent avant génération.
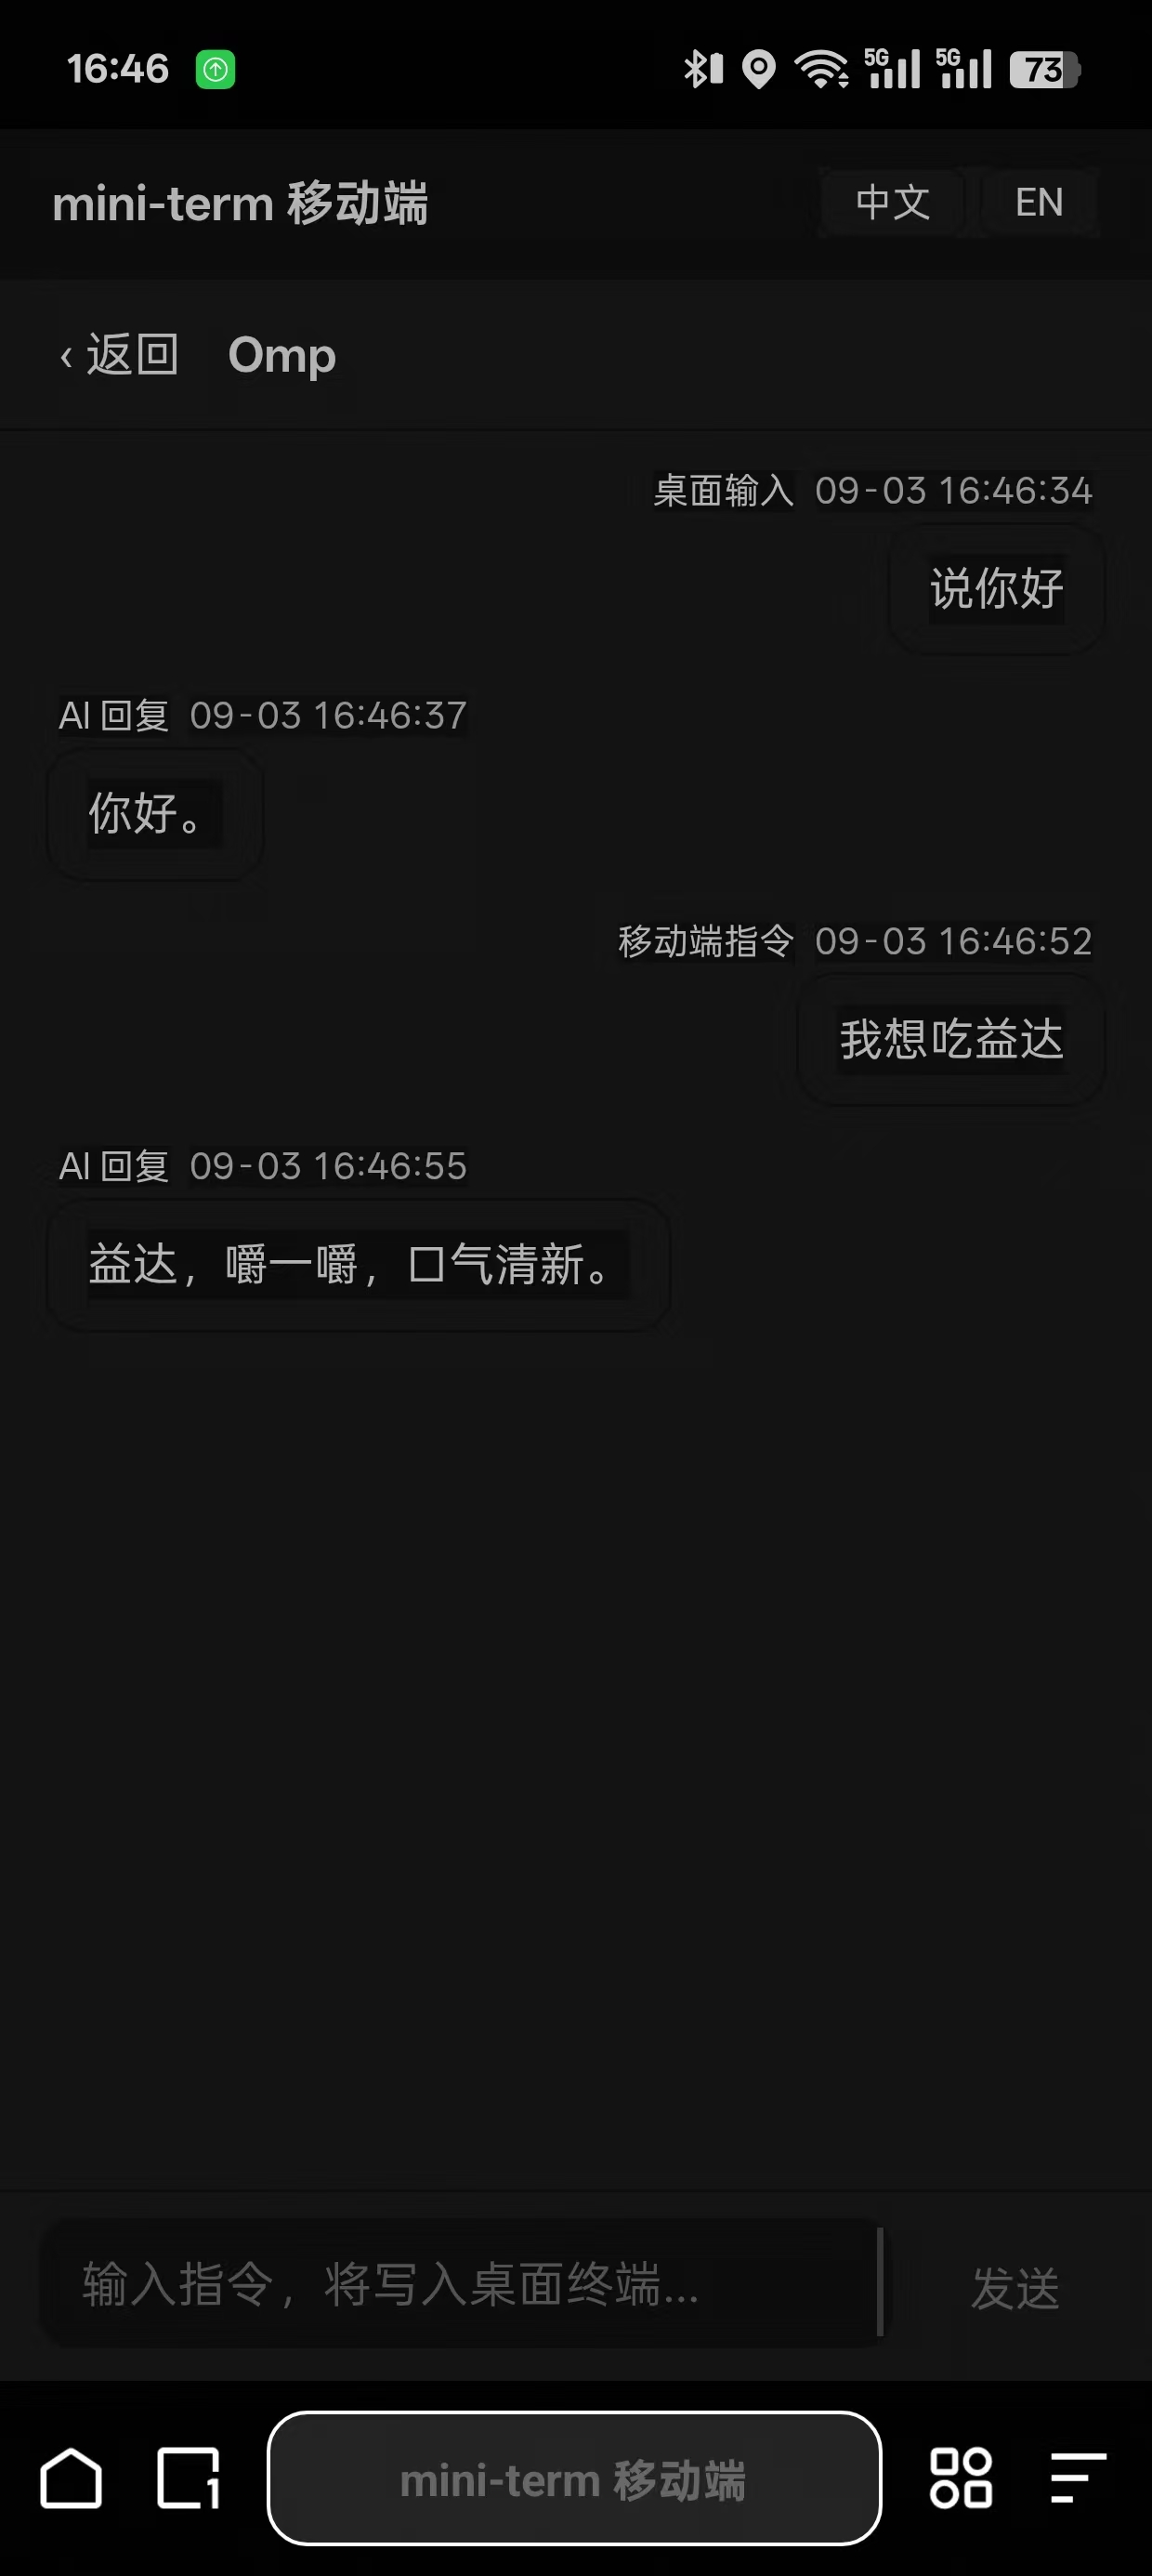
Mini-Term synchronise les conversations oh-my-pi sur mobile.
Mini-Term lit les sessions JSONL d’OMP, réplique réponses et questions vers le téléphone et transforme les tool calls `ask` en cartes interactives.
Le travail de recherche assisté par agents dépasse désormais les tâches ponctuelles de code. Chez OpenAI, mi-août, l’organisation de recherche consommait 3,1 journées-agent pour une journée humaine, tandis que le nombre d’expériences par chercheur atteignait un record. Les agents prennent davantage de tâches longues, mais les humains gardent priorités, arbitrage et décisions de déploiement.
Meta teste la même logique sur une évaluation externe. AIRA₃, présenté comme son système autonome de recherche IA, a fini 8e sur environ 4 000 équipes dans un concours Kaggle de fine-tuning Nemotron, noté sur un jeu privé. Le signal important est opérationnel : l’agent ne produit plus seulement du code, il optimise une capacité mesurée.
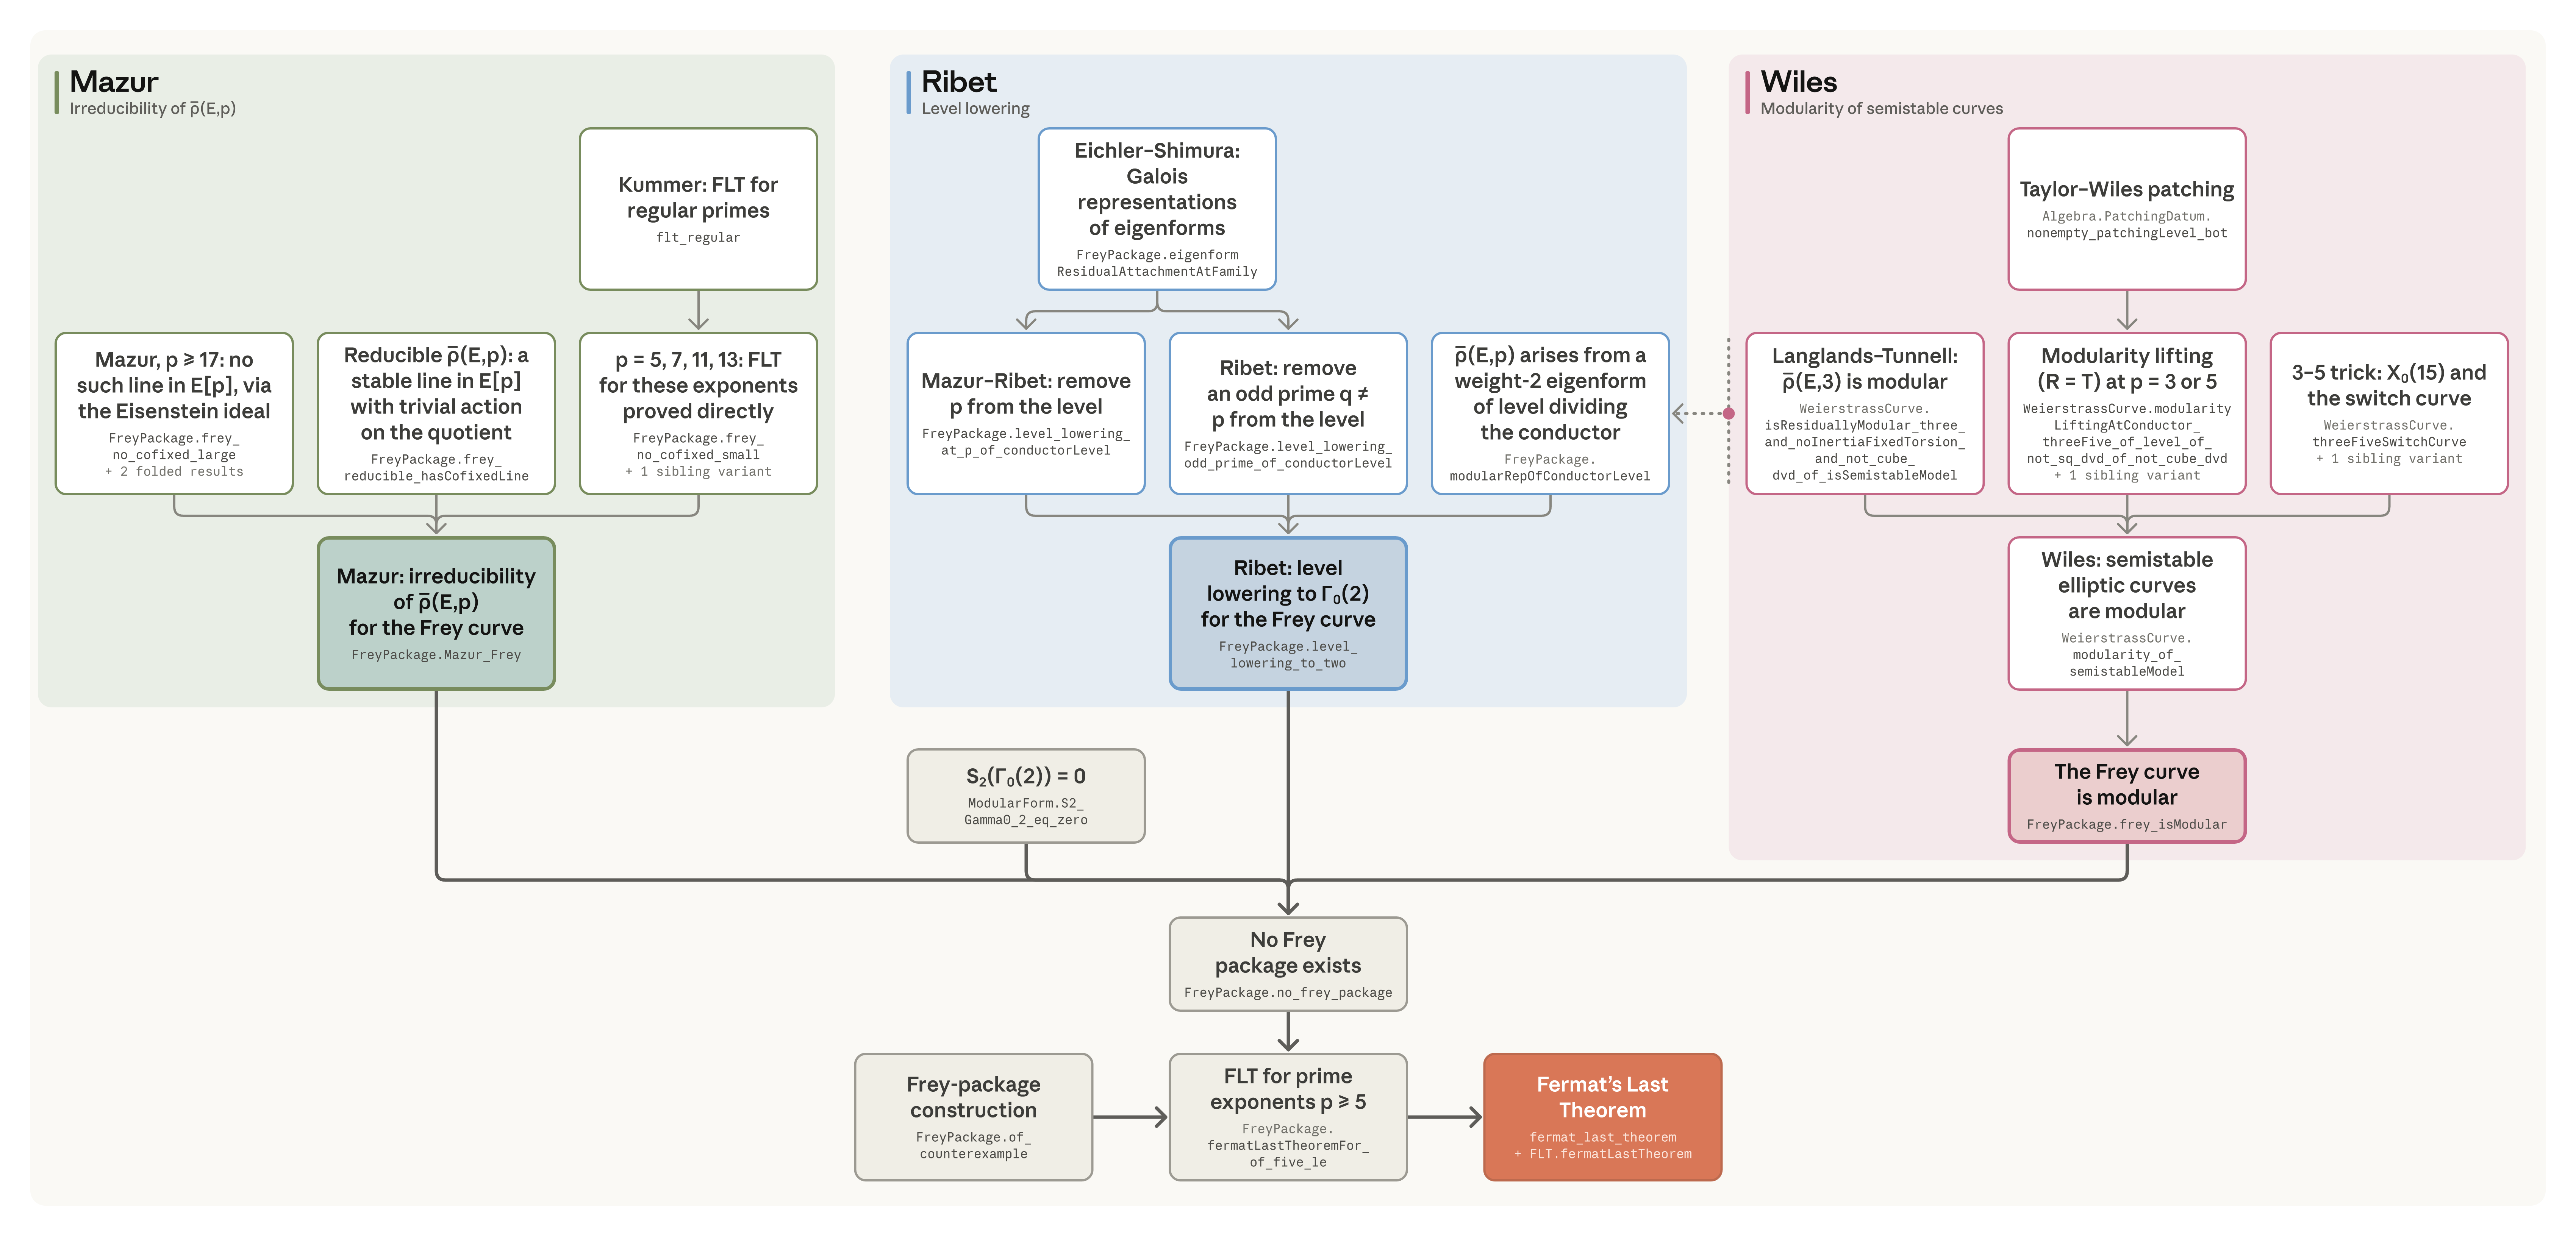
Anthropic pousse cette autonomie jusqu’à la vérification mathématique. Des agents Claude ont formalisé le dernier théorème de Fermat en Lean en onze jours, avec 13 millions de lignes et 29 500 théorèmes intermédiaires retenus. Pour les développeurs, l’agent harness doit désormais gérer état persistant, budget de calcul, parallélisme et vérification indépendante du résultat.

AgentLodge apprend la version de Claude Code du trafic pour éviter les refus de modèle.
Le proxy mémorise la version la plus récente observée chez ses clients et force Fable dans `/model`, évitant les rejets quand le minimum requis augmente.
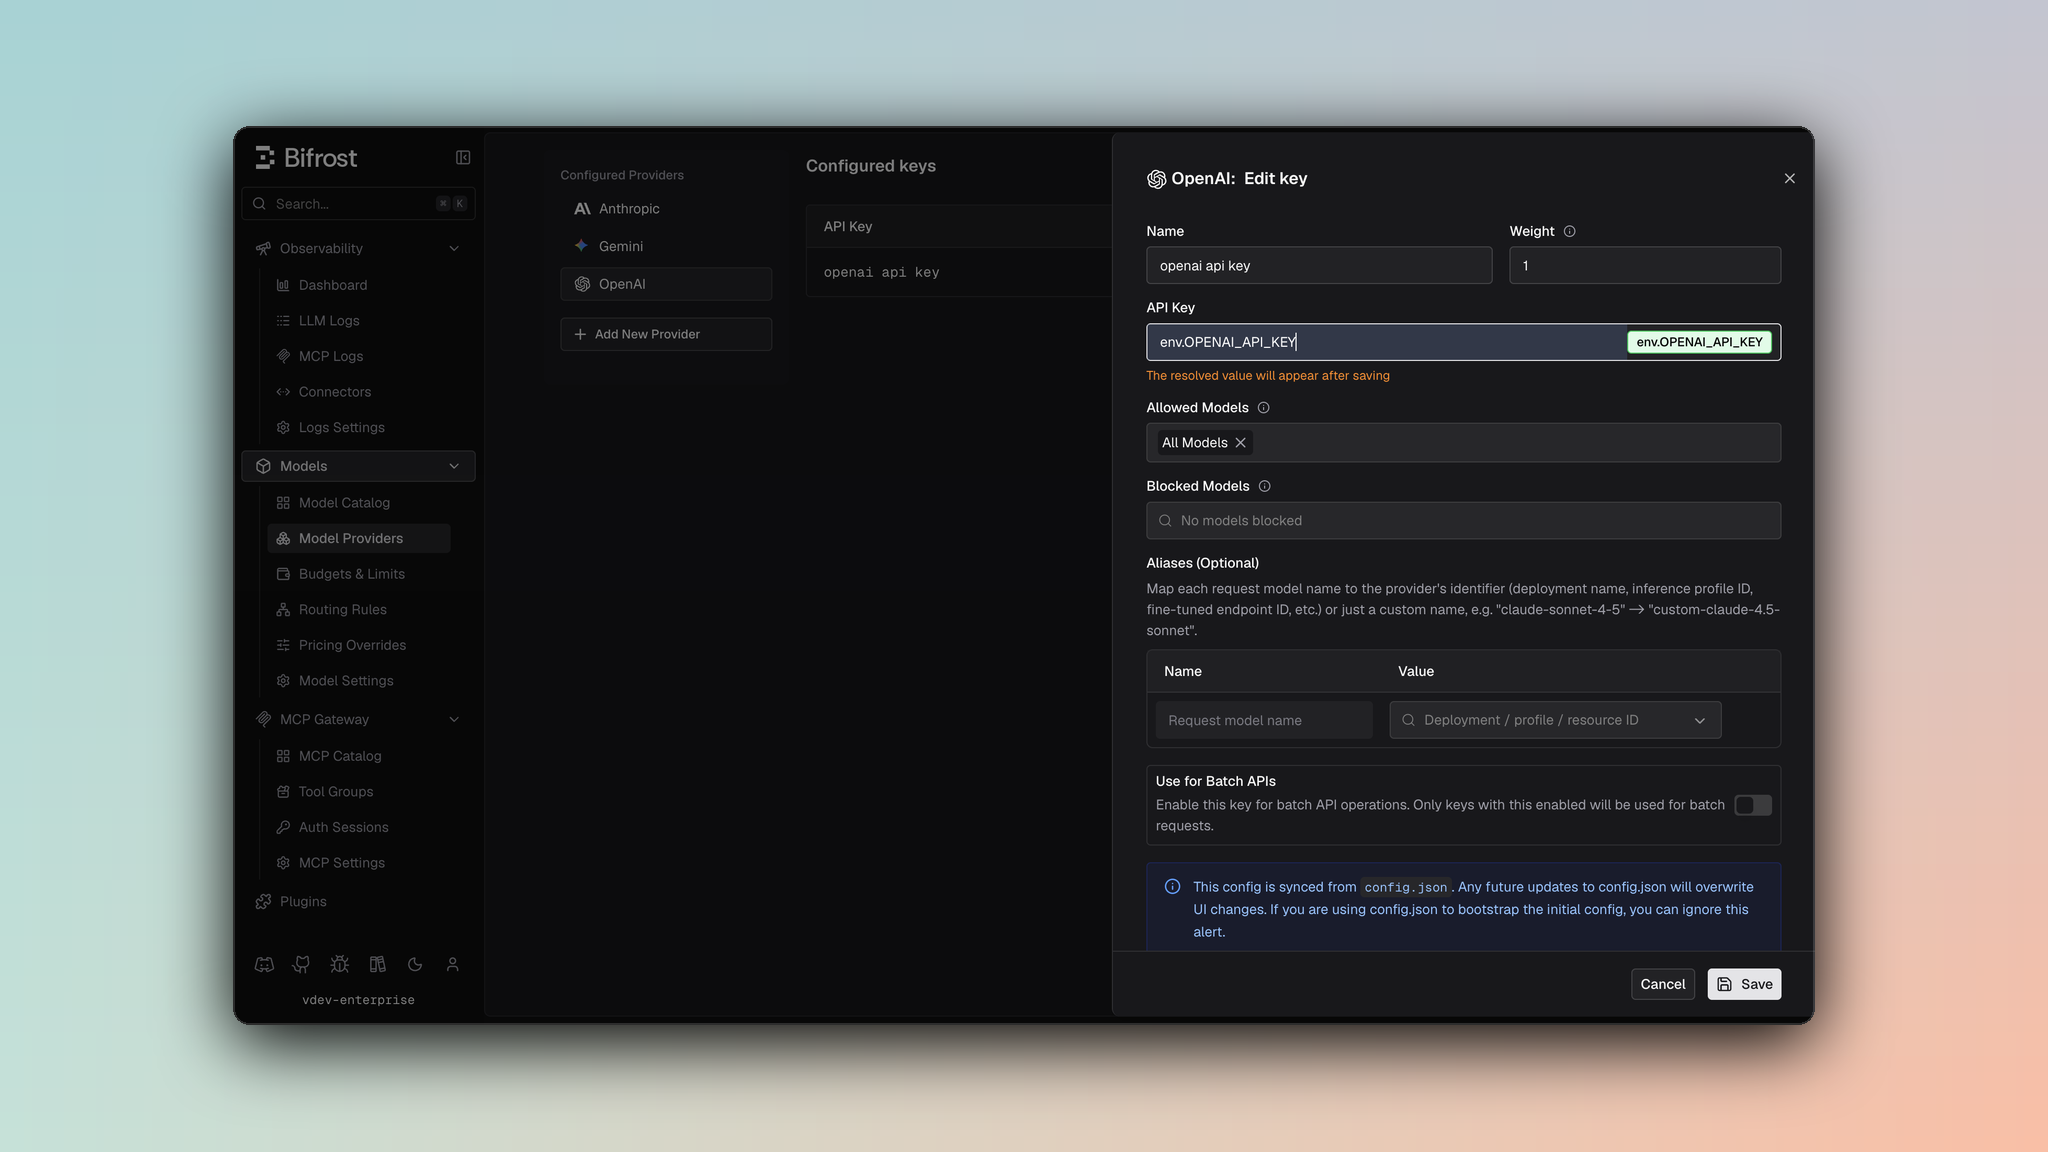
Bifrost corrige les tool calls Anthropic forcés vers OpenAI.
Bifrost convertit désormais `tool_choice: any` en `required` à la sortie OpenAI ; les appels Anthropic qui imposent un tool n’échouent plus en HTTP 400.
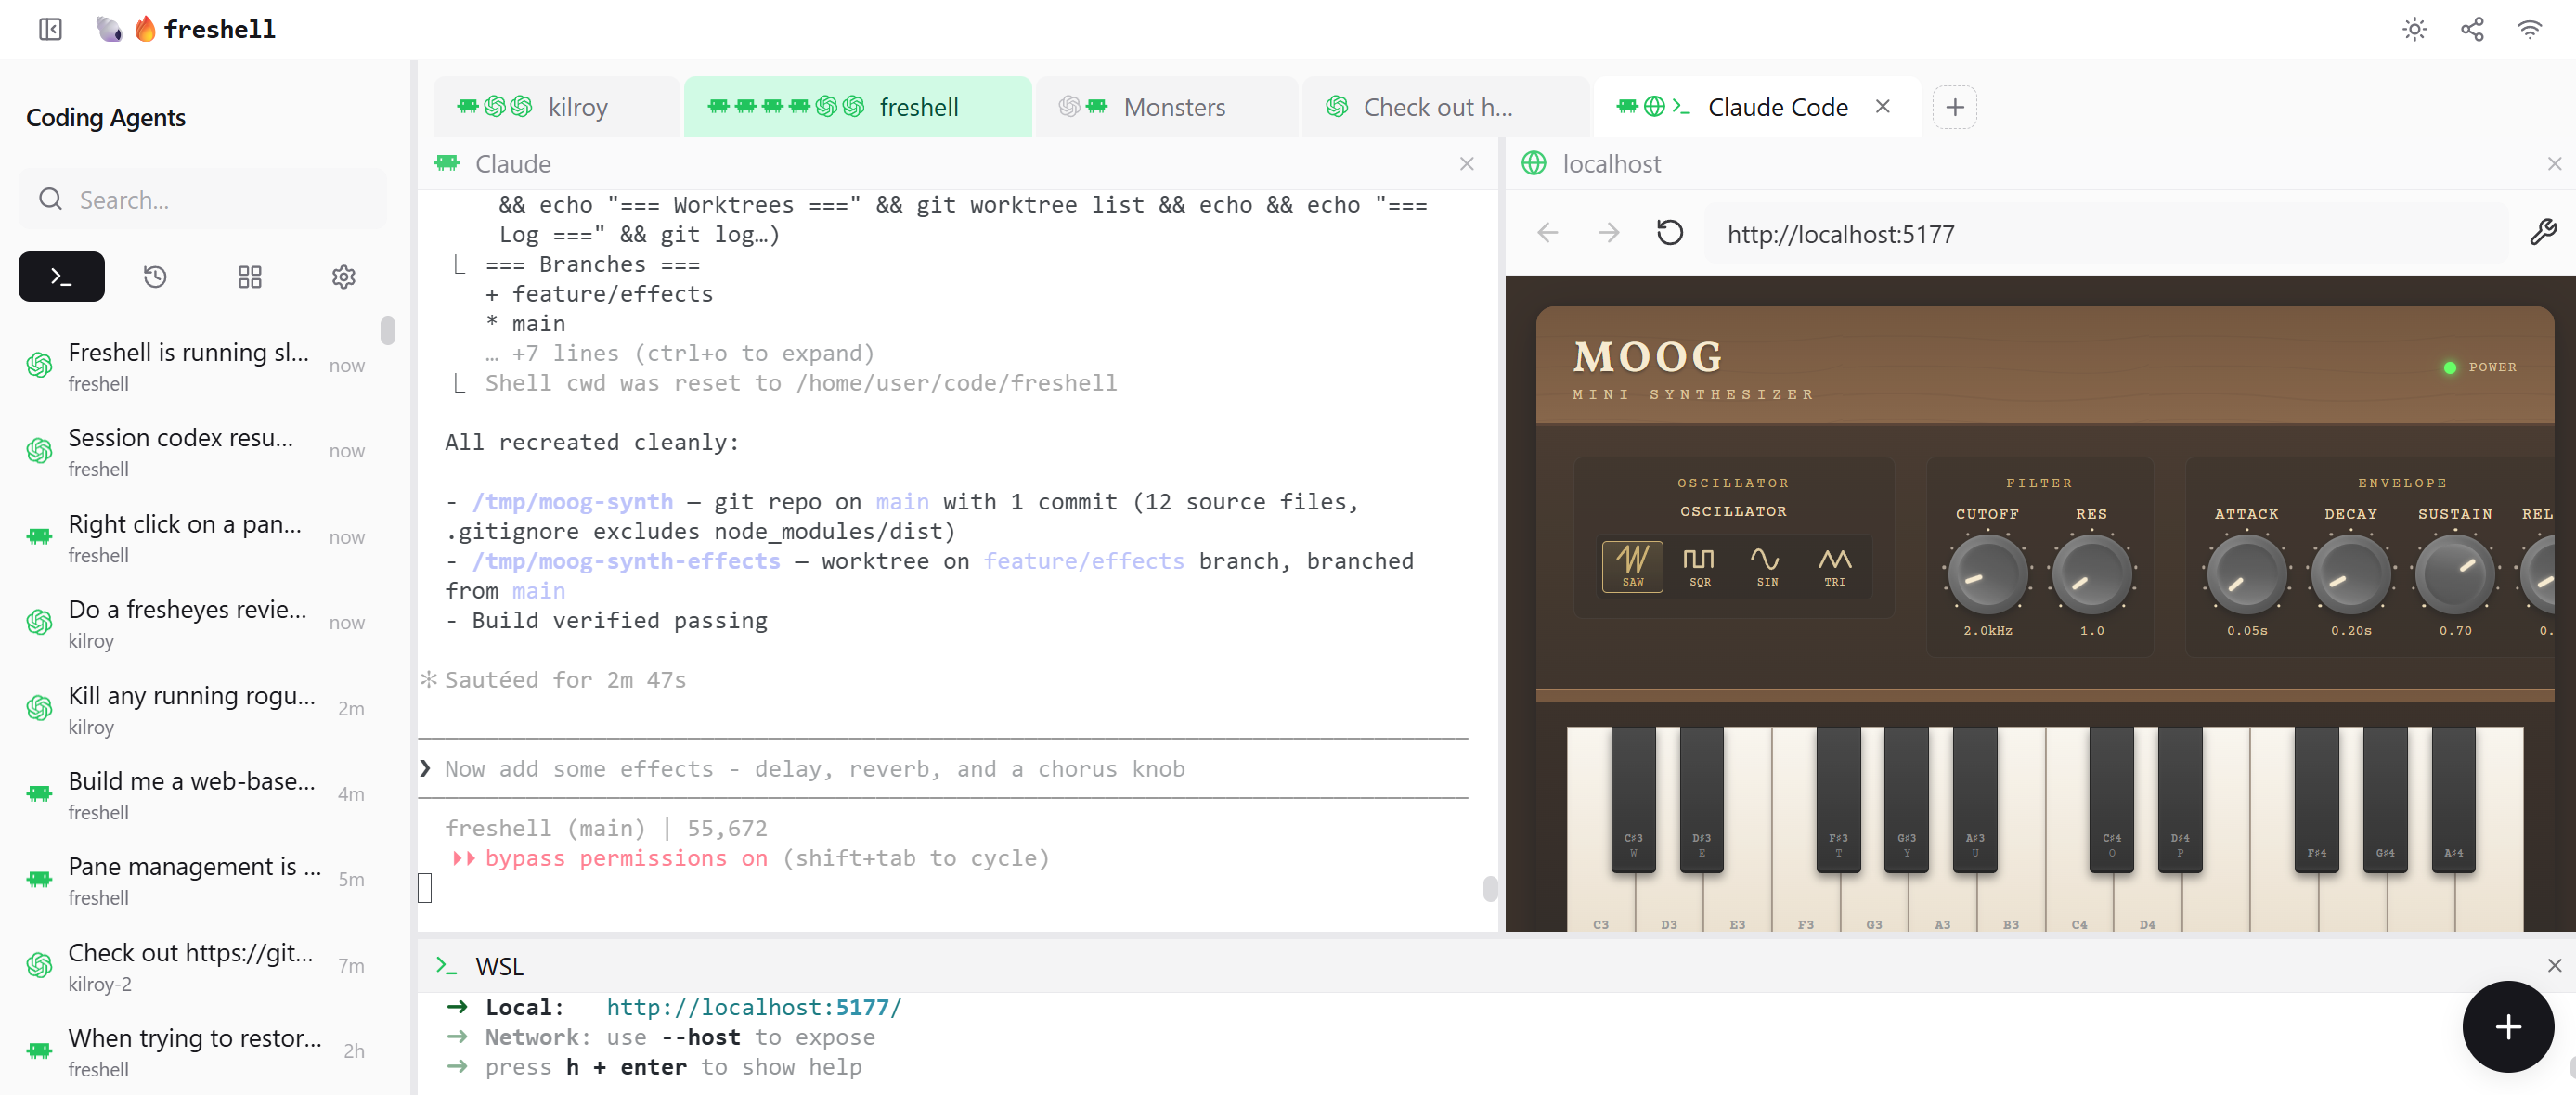
Freshcodex choisit GPT-6 Astra par défaut et simplifie ses profils de routage.
Freshell retire plusieurs modèles dépréciés, ajoute Astra au sélecteur et clarifie les profils Builder, Strategist et Speed utilisés par l’agent.
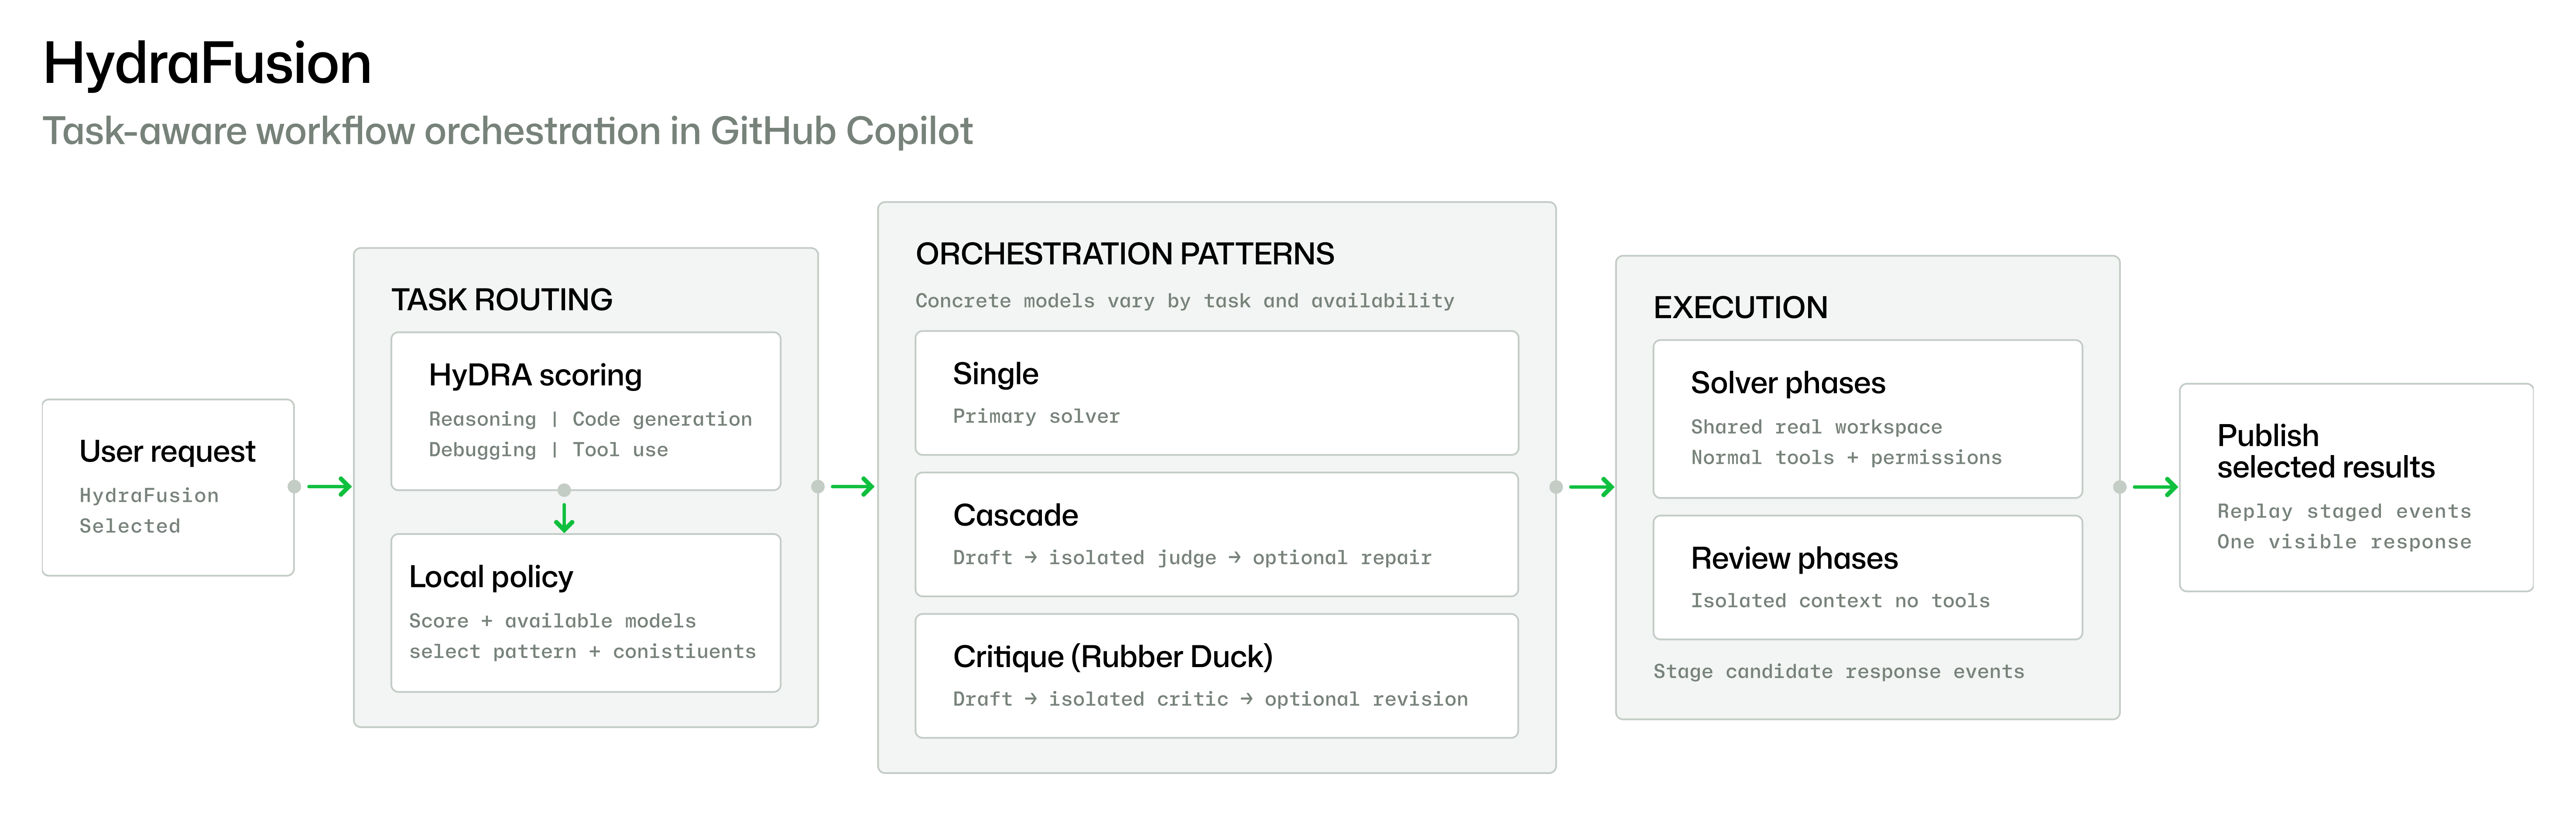
Le choix du modèle entre désormais dans le runtime des coding agents. HydraFusion, dans Copilot CLI, construit pour chaque tâche un workflow Single, Cascade ou Critique, puis choisit les modèles chargés de résoudre, relire ou escalader. Sur TerminalBench 2.1, GitHub annonce 67 % de coût estimé en moins qu’Opus 5, avec 4,9 points de qualité vérifiée en plus.
Spotify applique la même logique plus bas dans le harness. Son plugin `shunt` intercepte les lectures volumineuses de Claude Code et les délègue à un worker moins cher, ici Gemini 2.5 Flash, avant de renvoyer un résumé compact. L’équipe mesure environ 90 % de tokens en moins sur ses scénarios de lecture de gros fichiers.
CodeRabbit montre pourquoi ce routage devient une décision économique : sur son exemple de revue, GPT‑6 Astra coûte 1,50 dollar contre 0,60 pour GPT‑5.6 Sol, alors que son gain global de bugs détectés n’est que d’environ 4 %. Pour les développeurs, l’optimisation se déplace du modèle choisi vers la politique qui attribue chaque étape au bon niveau de capacité.
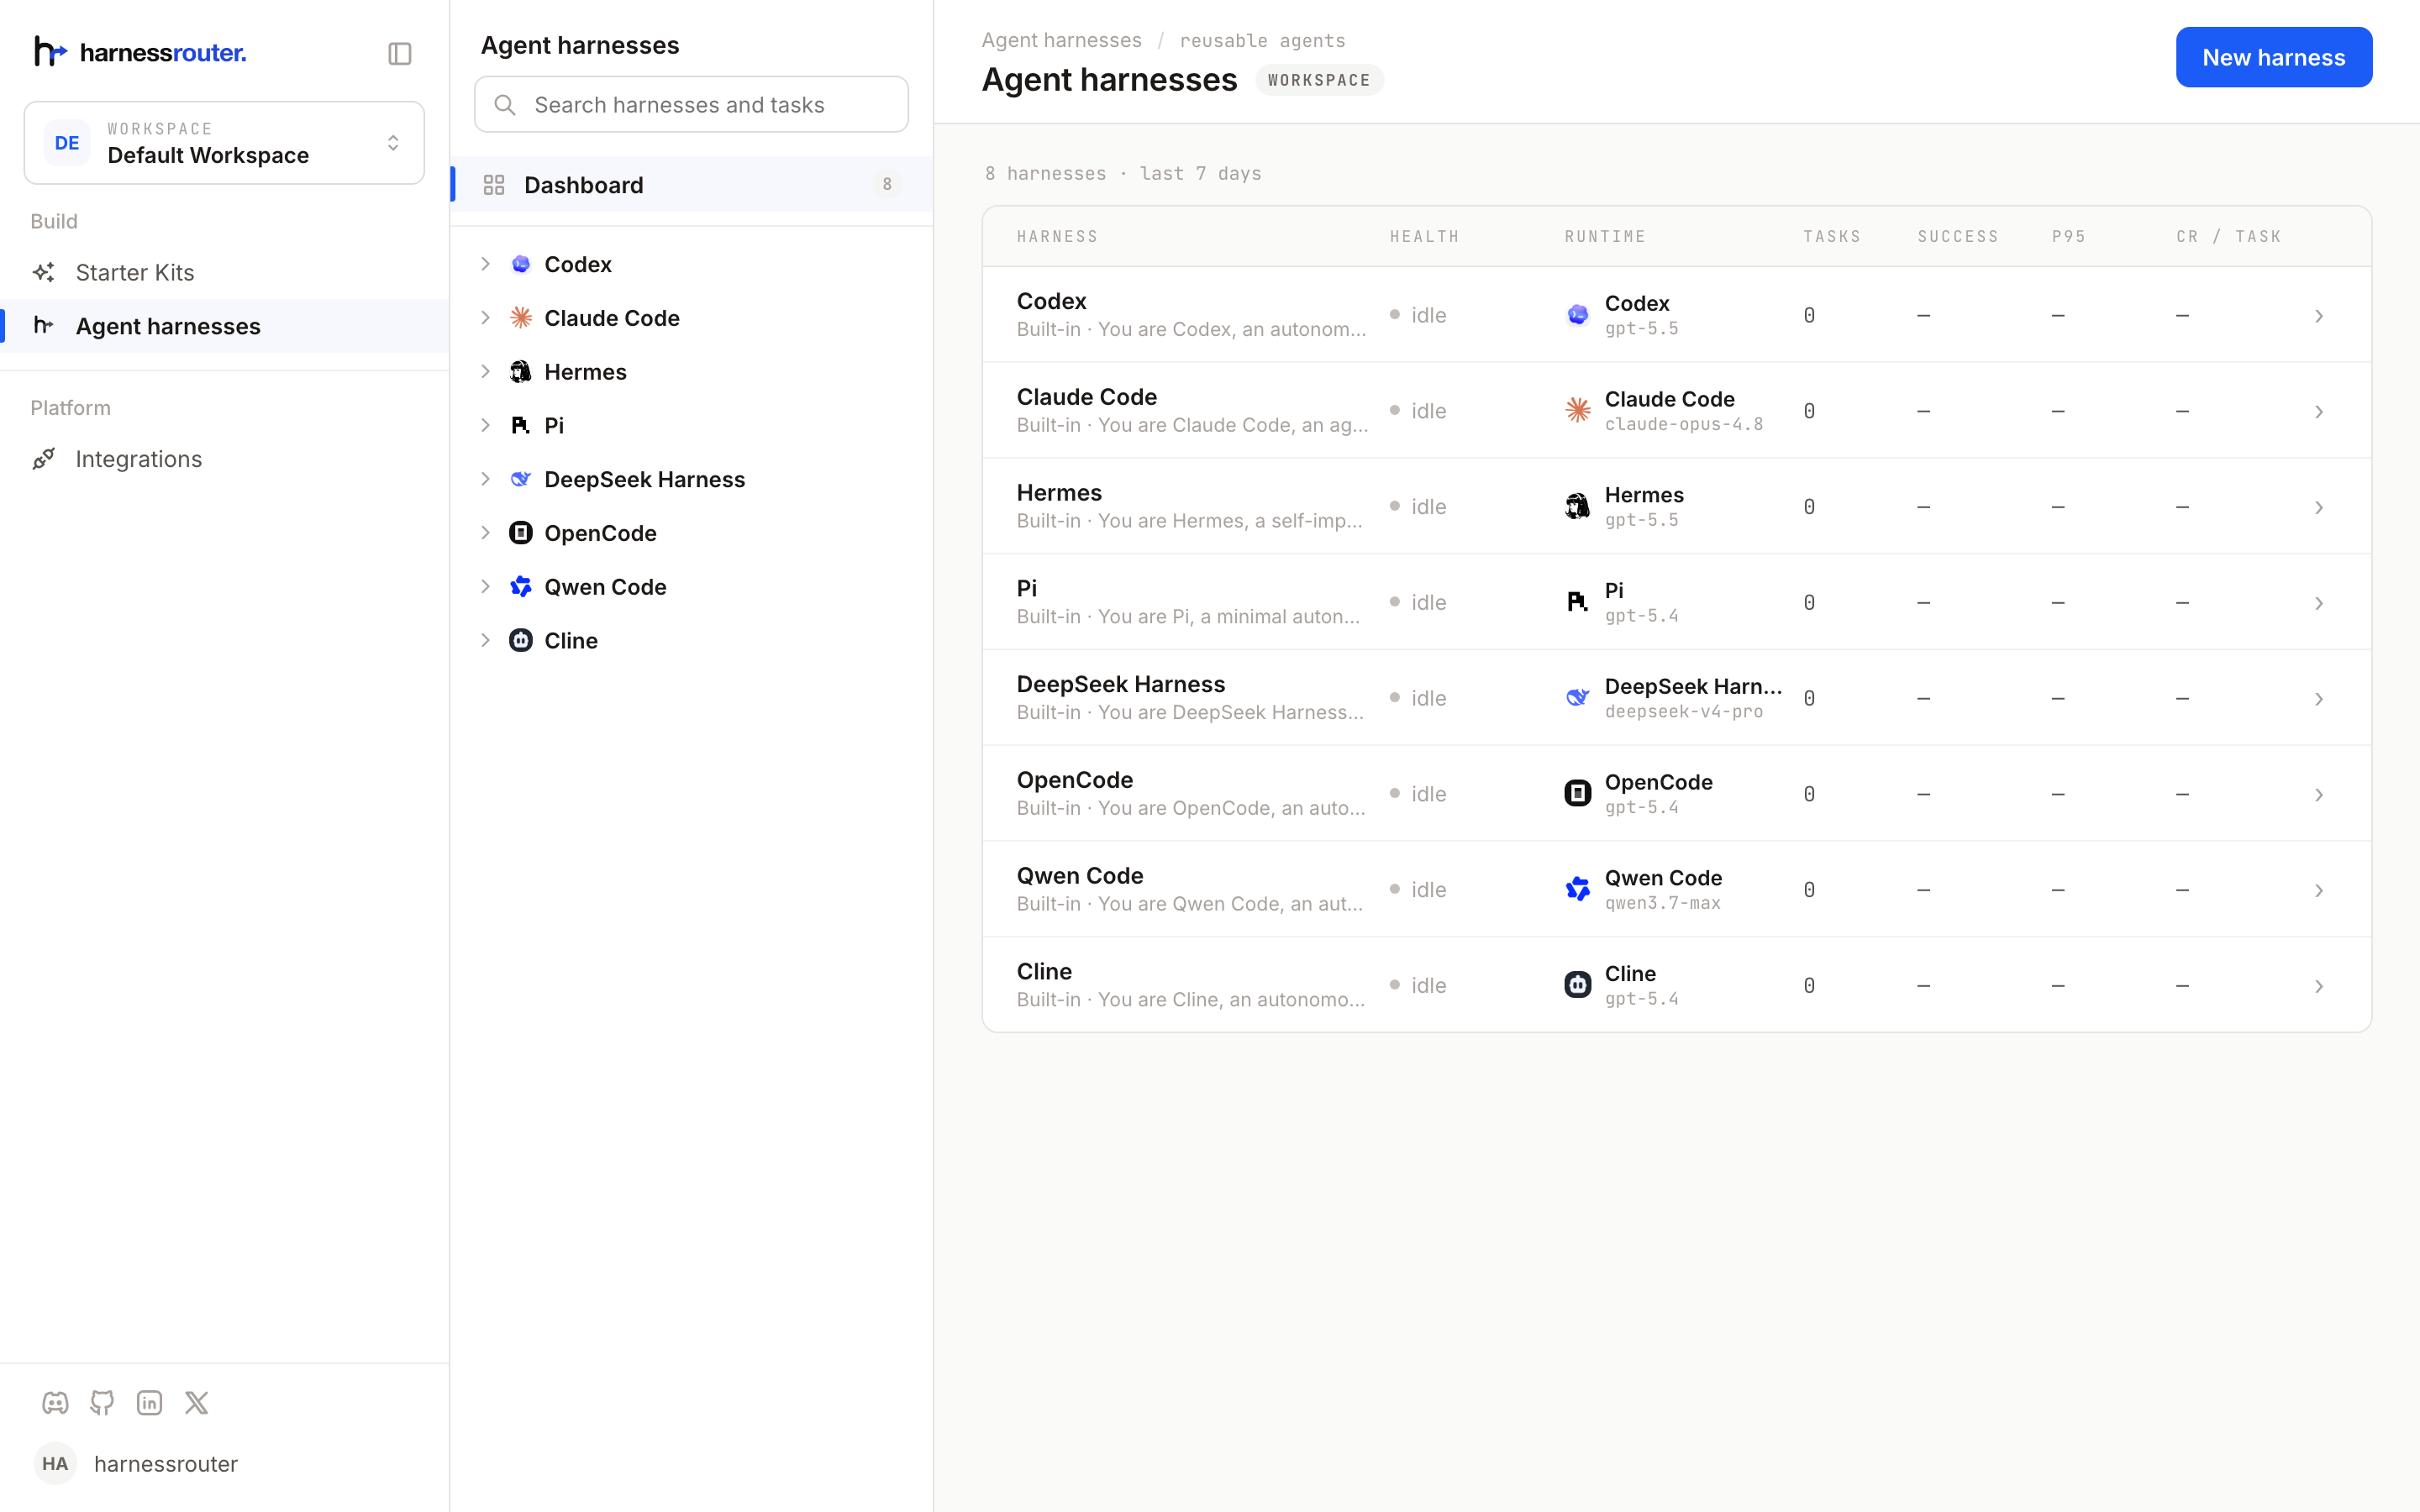
HarnessRouter ajoute Gemini CLI comme backend d’agent.
HarnessRouter prend désormais Gemini CLI comme backend, avec son schéma stream-json natif et un provider Google dédié ; les développeurs peuvent l’exécuter dans le même harness que Claude, Codex et Hermes.
Nessie réserve la publication MCP à un scope explicite.
Nessie ajoute `documents_publish`, non coché par défaut à l’appairage, et la découverte OAuth RFC 9728 ; un agent ne peut plus confondre droit d’écrire et droit de publier.