Neurometric lance un petit modèle dédié au tool calling sur TrustedRouter.
Le modèle transforme l’intention en appels conformes au schéma à 0,01 $/M token d’entrée et 0,10 $/M en sortie ; il peut servir de routeur ou d’exécuteur dans un agent.
Neurometric lance un petit modèle dédié au tool calling sur TrustedRouter.
Le modèle transforme l’intention en appels conformes au schéma à 0,01 $/M token d’entrée et 0,10 $/M en sortie ; il peut servir de routeur ou d’exécuteur dans un agent.
Anthropic augmente durablement de 25 % les limites hebdomadaires de Claude.
À partir du 14 septembre, les abonnements Pro, Max, Team et Enterprise par siège conserveront davantage de capacité ; le bonus temporaire de 50 % reste actif jusqu’au 13 septembre.
VT Code relie son coding agent à un éditeur WebMCP contrôlé par l’utilisateur.
Le nouveau client garde le terminal comme source de vérité et exige une validation humaine avant toute écriture dans les fichiers.
Les coding agents sortent du tête-à-tête entre un développeur et son terminal. VS Code déplace leurs sessions dans un processus dédié qui continue après la fermeture d’un dossier, reste synchronisé entre plusieurs fenêtres et accepte des connexions distantes. L’agent devient un travail durable, accessible depuis plusieurs interfaces.
Slack Code pousse ce mouvement vers l’équipe entière : une discussion crée un canal de projet où Claude Code, Devin, Copilot, ChatGPT ou les agents de Vercel partagent plan, diffs et aperçu exécutable. Les collègues peuvent suivre, corriger et valider le travail sans reprendre le contexte dans un autre outil.
Anthropic applique la même logique aux conversations d’entreprise avec Claude Tag, capable de lire le fil partagé et d’intervenir sans mention directe. Pour les développeurs, le vrai changement n’est donc pas un modèle supplémentaire : c’est une session observable, pilotable à plusieurs et indépendante de l’écran qui l’a lancée.
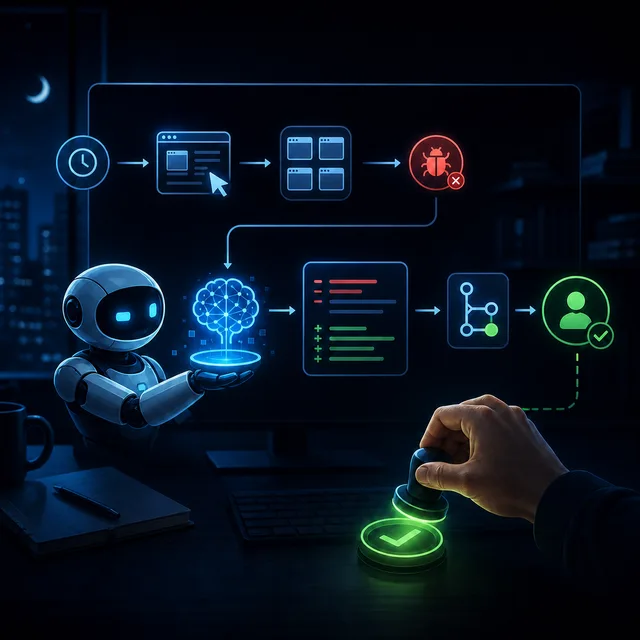
Muraqib confie à Claude les corrections après un test nocturne.
Le projet open source exécute Playwright chaque nuit, puis Claude prépare une pull request si un test échoue ; la fusion reste soumise à une revue humaine par défaut.
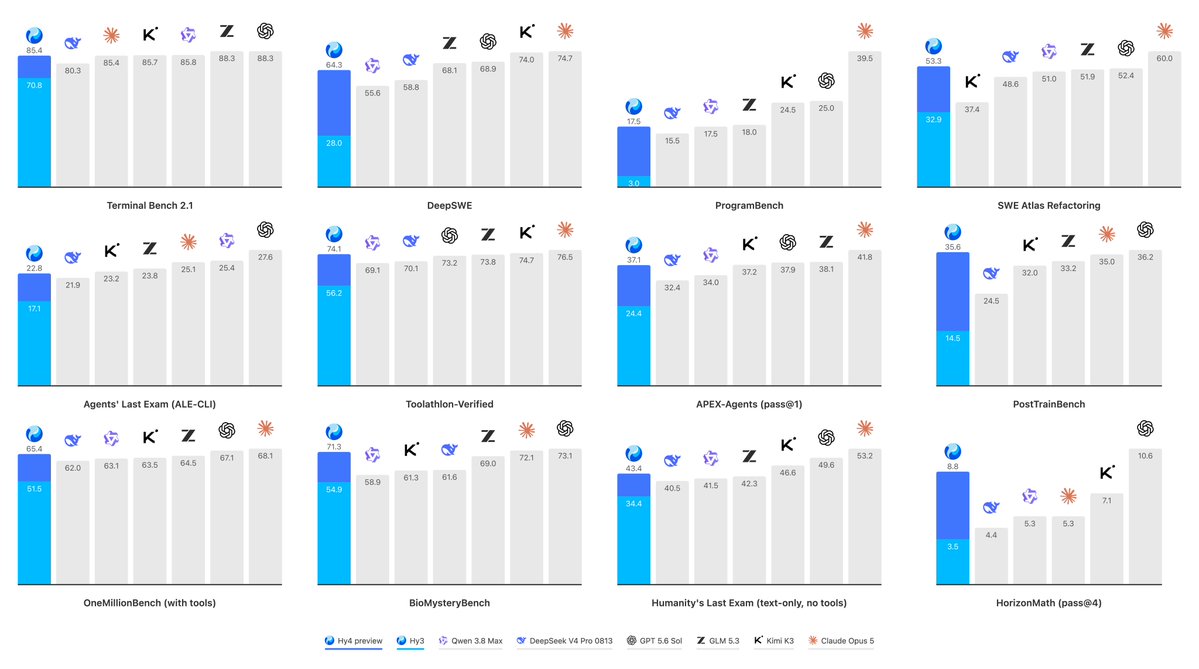
Tencent réduit Hy4 preview de 1,5 To à 214 Gio en GGUF mixte.
MIX-STQ1_0 descend à 2,38 bits par poids, avec une baisse limitée sur MCP Atlas, SWE-Bench multi, MRCR et IFBench ; les poids sont publiés sur Hugging Face.
Le coût d’un agent de code se déplace du modèle vers le logiciel qui l’entoure. Des comparaisons récentes montrent qu’un même modèle peut consommer des volumes de tokens très différents selon son agent harness, son prompt système, ses outils, son nombre de tours et la façon dont le cache est exploité.
Cette couche devient aussi entraînable. EvoHarness-RL, présenté par des chercheurs de Meta et de l’Université de l’Illinois, apprend à un modèle quand lire, mettre à jour ou consolider son état externe. Sur ALFWorld, Qwen3-8B atteint 96,9 % de réussite, contre 47,9 % pour la base ReAct.
Pour les équipes, choisir un modèle ne suffit donc plus à prévoir qualité, latence ou facture. Les benchmarks cités par The New Stack et TechGig montrent des écarts de coût par tâche réussie et de consommation de tokens selon le harness. La prochaine optimisation porte sur le contexte envoyé, le cache et les boucles d’exécution.
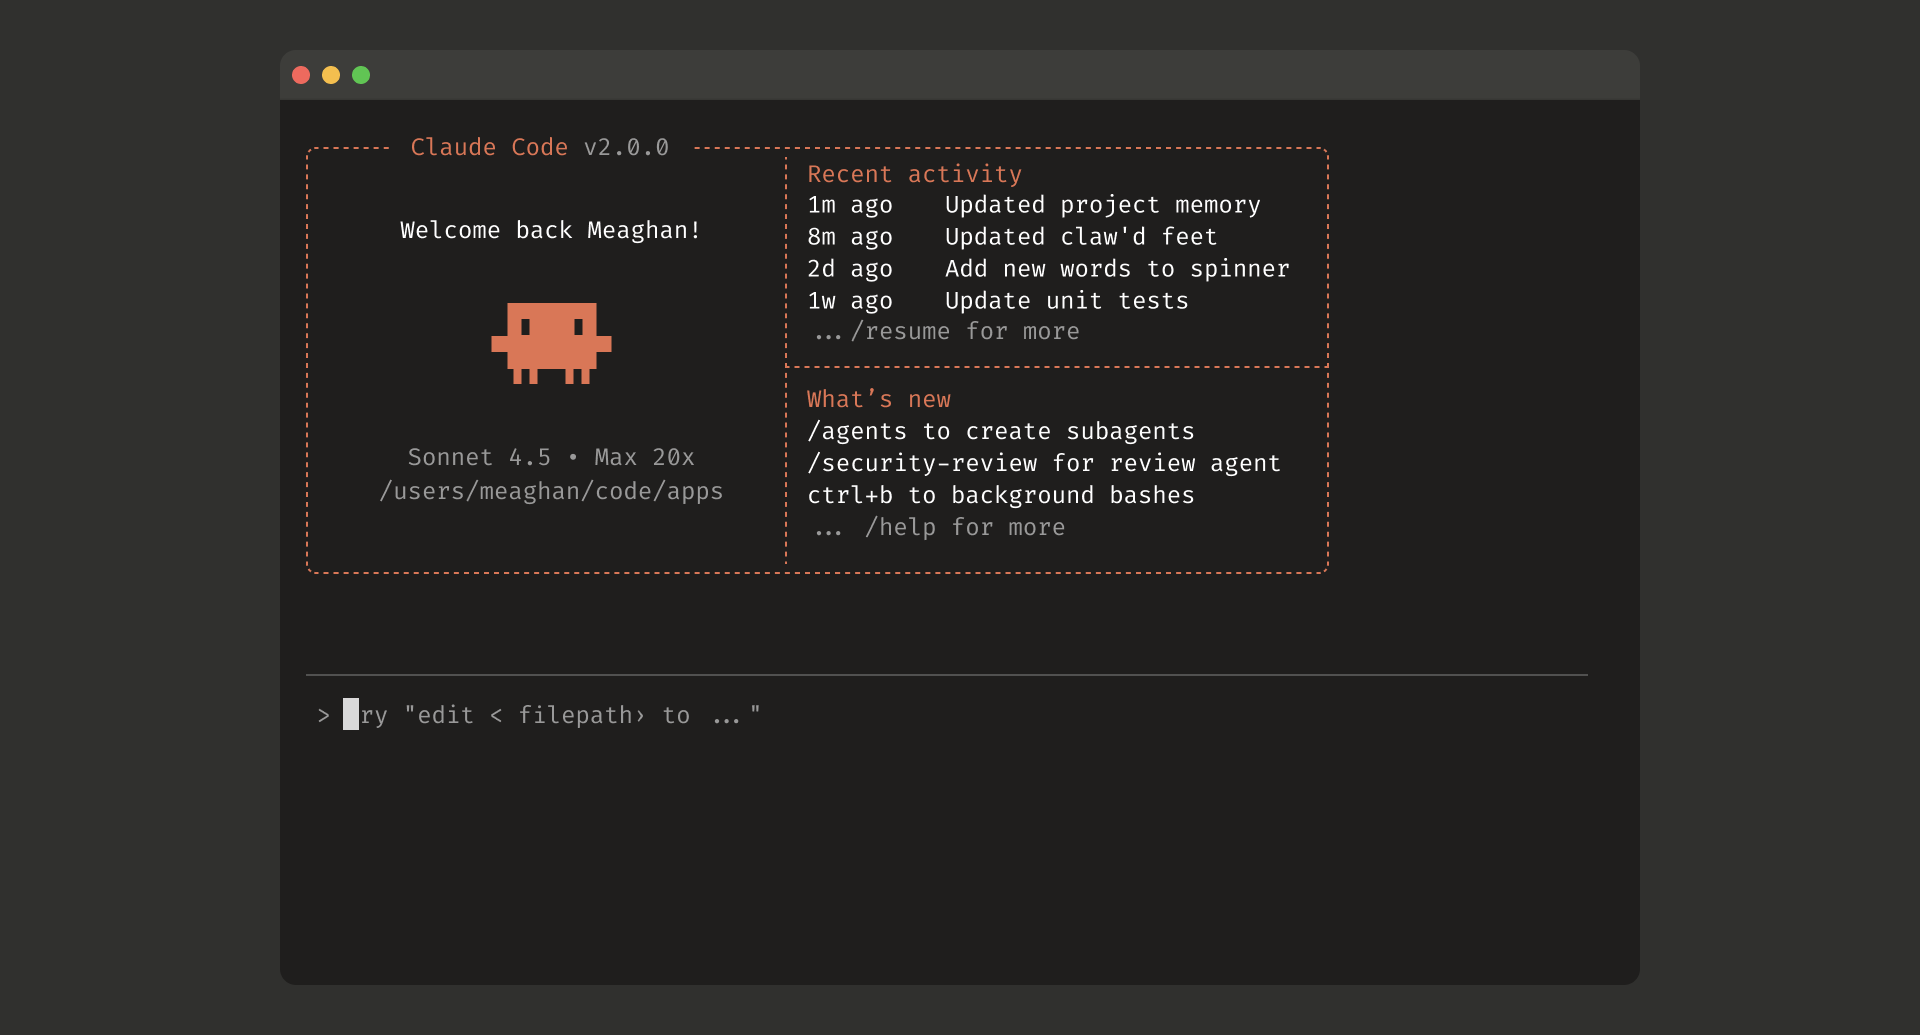
Claude Code accélère son CLI et réduit son binaire Linux à 75 Mo.
Anthropic fait démarrer le CLI avant le sandbox et les serveurs MCP, réduit le téléchargement Linux x64 de 4,5× et détaille mieux l’usage des tokens dans `/cost`, `/usage` et `/tasks`.