Les agents répartissent désormais leur calcul entre cloud et machines locales
Google fait du local un mode natif d’Antigravity SDK : Gemma 4 26B peut exécuter un agent complètement hors ligne via LiteRT, tandis qu’un Gemini cloud ne reçoit que le plan. Dans sa démonstration, 97,2 % des tokens restent sur la machine et aucun code source n’est envoyé au cloud.
rabbit applique ce partage au poste de travail. OS3 choisit sur quel ordinateur exécuter une tâche, peut déplacer le travail entre plusieurs machines et accepte aussi bien une clé de fournisseur qu’un modèle hébergé localement. Les fichiers restent sur le poste ; le cloud conserve surtout conversation, mémoire et orchestration.
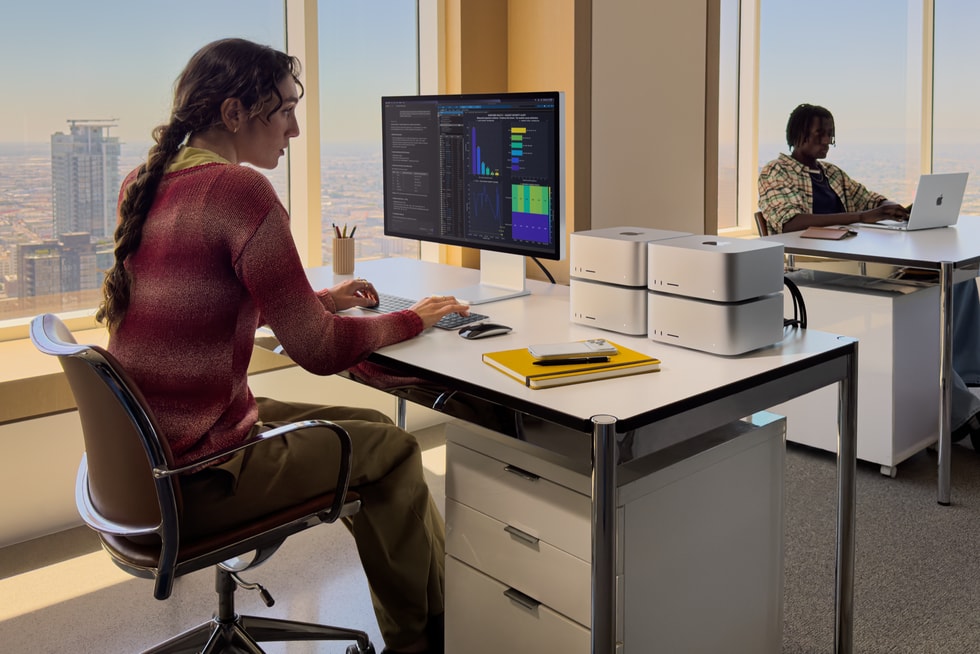
Apple pousse enfin le matériel dans la même direction : le Mac mini M6 vise les workflows d’agents en continu, tandis que le Mac Studio peut embarquer jusqu’à 512 Go de mémoire unifiée et même être regroupé pour l’inférence distribuée. Pour les développeurs, l’architecture d’un agent devient donc un problème explicite de placement du calcul.
Sources
Chaque onglet présente la publication d’origine et son lien direct.
Introducing Support for Local AI Models in the Antigravity SDK
Google ajoute à Antigravity SDK l’exécution locale et hors ligne via LiteRT et Gemma 4 26B, avec compatibilité pour des serveurs OpenAI-like comme Ollama, LM Studio ou vLLM. La démonstration hybride confie la planification à Gemini 3.8 Flash et l’audit, le patch et les tests à des workers locaux.
rabbit unveils OS3: the agentic operating system for every device
rabbit lance OS3, qui orchestre jusqu’à cinq machines et choisit où exécuter chaque tâche. Le système accepte des clés de fournisseurs ou des modèles hébergés localement, conserve les fichiers sur les postes connectés et peut déplacer le travail entre PC locaux, VM cloud et autres appareils.
The new Mac mini and Mac Studio are available today
Apple met en vente le Mac mini M6 et le Mac Studio M5 Max/M5 Ultra en les positionnant pour l’IA on-device et les workflows agentiques. Le Mac Studio monte jusqu’à 512 Go de mémoire unifiée et peut être regroupé via RDMA pour accélérer l’inférence distribuée.