Réécritures et dette technique passent aux coding agents, avec validation à chaque étape
GitHub a porté le runtime de Copilot de 430 000 lignes TypeScript vers plus de 800 000 lignes Rust avec des agents, en avançant module par module sur plus de 135 releases. Le projet a coûté environ 120 000 dollars de tokens, mais a aussi révélé des dizaines de régressions que la compilation seule n’avait pas détectées.
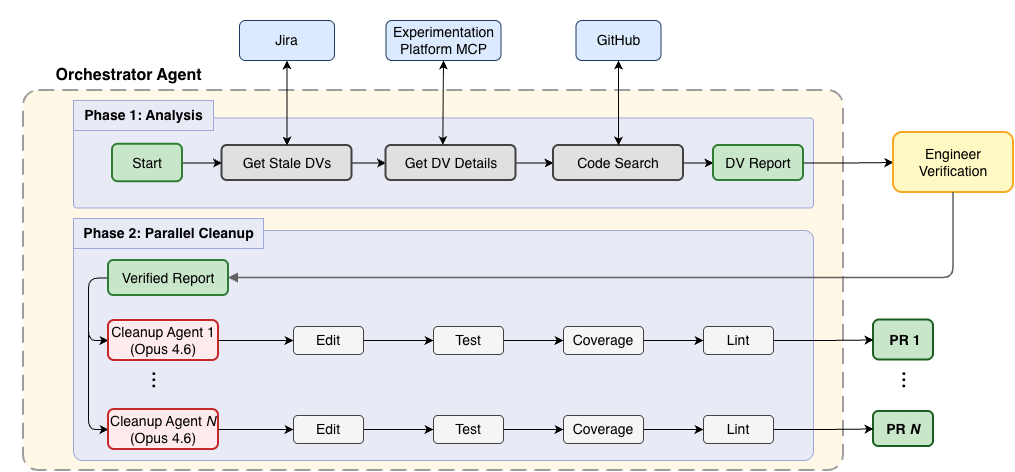
DoorDash applique la même logique à la dette technique récurrente : des agents nettoient les feature flags périmés dans des worktrees isolés, puis exécutent build, tests, couverture et lint avant d’ouvrir une pull request. Sur 50 cas évalués, 45 ont produit une PR exploitable en 13,8 minutes et 4,79 dollars en moyenne.
Android Bench 2.0 montre toutefois la limite actuelle : sur des tâches longues de migration ou refactoring, le meilleur taux de réussite plafonne autour de 28 %. Les modèles réussissent mieux les transformations déterministes, même sur plus de 125 fichiers, que les changements dépendant du runtime ou d’une architecture implicite. Le bon workflow reste donc borné, incrémental et vérifiable.
Sources
Chaque onglet présente la publication d’origine et son lien direct.
Microsoft agentically ports Copilot runtime to Rust for $120K
The Register détaille le port du runtime GitHub Copilot de TypeScript vers Rust avec des coding agents : environ 430 000 lignes source sont devenues plus de 800 000 lignes de Rust au fil de plus de 135 releases. Le chantier a coûté environ 120 000 dollars de tokens et a révélé plusieurs dizaines de régressions malgré la compilation réussie.
DoorDash Uses Multi Agent LLMs to Clean up 60,000 Feature Flags
InfoQ décrit le système multi-agent de DoorDash pour nettoyer les feature flags périmés. Les agents travaillent dans des Git worktrees isolés et doivent passer build, tests, couverture JaCoCo et analyse Detekt avant d’ouvrir une pull request. Sur 50 flags évalués, 45 ont produit une PR exploitable.
Android Bench 2.0: Pushing the frontier with challenging long-horizon tasks
Google étend Android Bench aux tâches longues comme migrations, refactorings et portages. Le meilleur pass rate atteint environ 28 %. Les agents réussissent mieux les transformations déterministes, y compris sur plus de 125 fichiers et 8 000 lignes, que les changements exigeant validation runtime ou compréhension architecturale implicite.