La mémoire d’un agent vaut par les erreurs qu’elle lui évite
Un nouveau banc d’essai public sépare désormais la mémoire textuelle de la mémoire des agents de code, avec une même interface d’ajout et de recherche. Son parcours dédié vérifie la capacité à retrouver puis réutiliser des expériences de débogage, des décisions d’ingénierie et le contexte historique d’un dépôt.
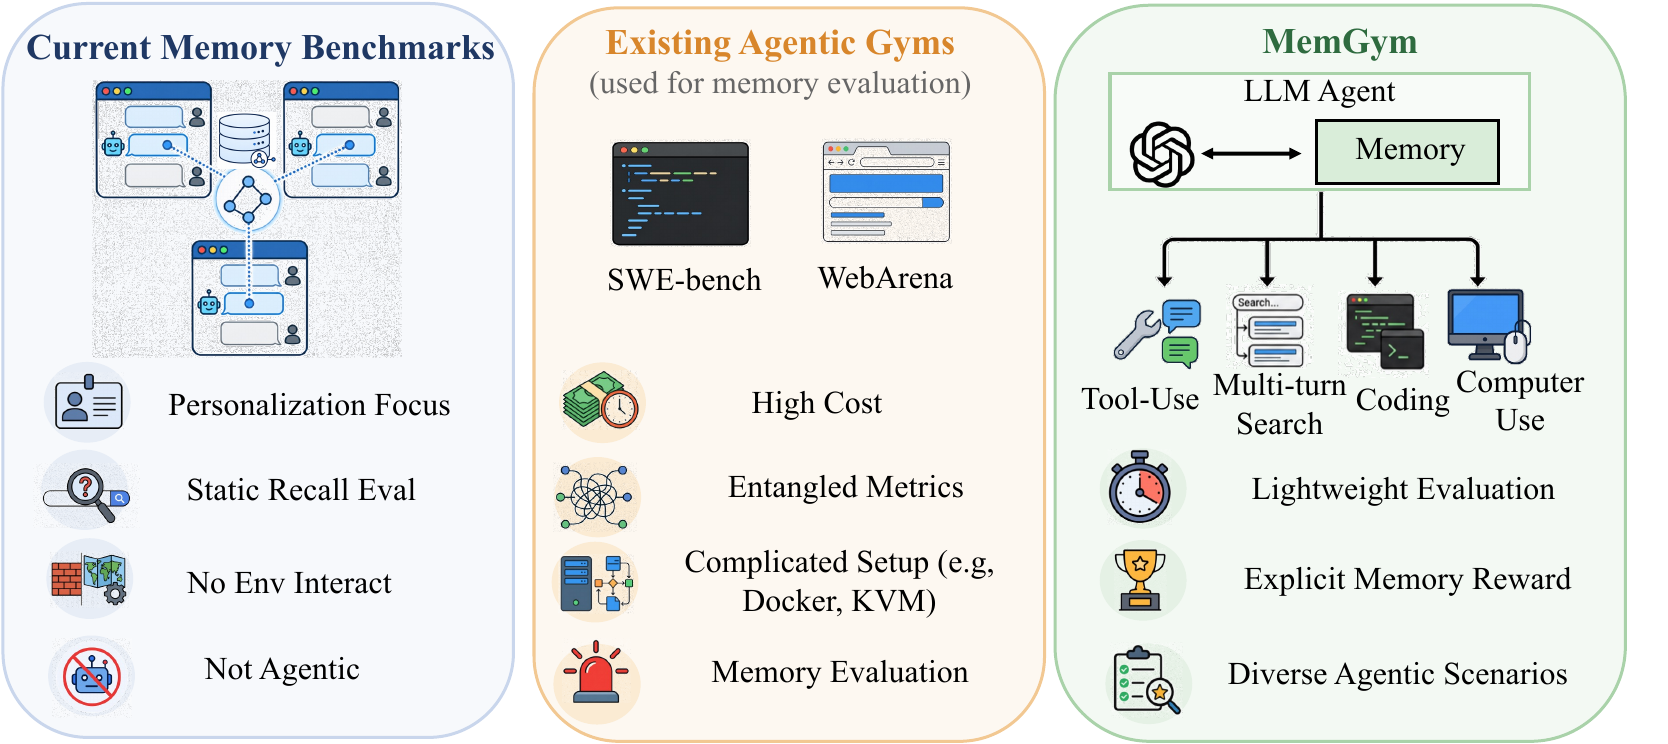
Cette cible resserre le diagnostic. MemGym isole l’apport de la mémoire du raisonnement et des outils sur cinq pistes, dont SWE-Gym et CodeQA ; MemoryArena enchaîne des tâches dépendantes sur plusieurs sessions. Les deux montrent qu’un excellent rappel conversationnel ne garantit ni une bonne décision ultérieure, ni un meilleur patch.
Pour les équipes, la métrique utile devient l’effet sur le travail : contexte pertinent retrouvé, exploration évitée, erreur corrigée et comportement amélioré à la session suivante. Agent Retrieval Bench confirme l’écart : les trajectoires manquent tous les fichiers pertinents dans 27 à 35 % des cas. À surveiller : des résultats publics reproductibles sur du code réel.
Sources
Chaque onglet présente la publication d’origine et son lien direct.
Agent Memory Leaderboard
Ce banc d’essai public sépare la mémoire textuelle de la mémoire des agents de code sous un protocole commun Add/Search. Le parcours code évalue la récupération, le filtrage et la réutilisation d’expériences de débogage, de développement et de contexte projet ; les méthodes académiques et les produits commerciaux disposent de tableaux distincts.
MemGym: a Long-Horizon Memory Environment for LLM Agents
MemGym réunit cinq pistes couvrant dialogue avec outils, recherche, code et navigation. Son protocole compare chaque stratégie à un agent doté du même raisonneur mais privé de mémoire, afin d’isoler l’apport de celle-ci. Les pistes de code s’appuient notamment sur SWE-Gym et MEMGYM-CODEQA.
Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks
MemoryArena construit des tâches humaines interdépendantes réparties sur plusieurs sessions : l’agent doit tirer une leçon d’une action ou d’un retour, la conserver, puis l’utiliser plus tard. Les auteurs constatent que des agents presque saturés sur les tests de long contexte restent faibles lorsque mémoire et décision sont réellement couplées.
Agent Retrieval Bench: Evaluating Repository Context Retrieval for Coding Agents
Ce benchmark couvre 427 cas dans 25 dépôts et mesure les fichiers qu’un agent doit trouver avant d’éditer. Aucun moteur de recherche ne domine toutes les tâches ; dans les trajectoires observées, l’agent ne lit aucun fichier pertinent sur 27 à 35 % des exemples, ce qui sépare nettement rappel de contexte et réussite du patch.